

準1級文系解説について(各回共通)
ご訪問いただきありがとうございます。こちらは統計検定🄬準1級合格を目指す方が、公式テキスト『統計学実践ワークブック』やそのほか統計検定🄬準1級対策コンテンツをスラスラと学び進めるために必要な解説を行うブログです。
本ブログは、公開されている「統計検定🄬準1級出題範囲」の各項目について執筆しています。「統計検定🄬準1級出題範囲」は『統計学実践ワークブック』の内容にも対応していますので、本ブログの解説が『統計学実践ワークブック』の読解に役立つ部分も多くあるかと思います。その意味で、本ブログをご覧いただく方には、公式テキスト『統計学実践ワークブック』を購入されることを推奨いたします。
なお、統計検定🄬は一般財団法人統計質保証協会の登録商標です。また、本ブログは一般財団法人統計質保証協会から公認されたコンテンツではありません。
00. はじめに
統計学では、データの背後にある「確率のしくみ」を数理的に捉えるために、状況に応じた確率分布を使い分けます。本記事では、その中でも「数を数える」タイプのデータ、つまり、0回・1回・2回…といった離散的な値をとる確率変数に対応する分布をまとめて学んでいきます。
たとえば、
- 「10回の試行のうち、何回成功するか」
- 「1回成功するまでに、何回失敗が続くか」
- 「一定時間内に、何件の事象が発生するか」
- 「全体の中から無作為に取り出したとき、対象が何個含まれるか」
といった場面は、どれも「数える」という点では同じですが、前提となる条件が異なるため、使うべき確率分布も変わります。
本記事では、ベルヌーイ分布/二項分布/ポアソン分布/超幾何分布/幾何分布/負の二項分布/多項分布といった代表的な離散型分布をとりあげ、それぞれについて
- どんな状況で現れるか(前提・モデル化)
- 確率関数/期待値・分散/確率母関数
- 他の分布との関係や特徴的な性質
を、図表とともに整理していきます。
また、記事の最後には、これらの分布の 「つながり」 をひと目で俯瞰できる確率分布マップも掲載しています。個別の分布を「暗記する」のではなく、前提の違いによって分布が分岐していく流れとして理解することが、本記事のねらいでもあります。ぜひ本記事をブックマークしていただき、離散型確率分布を「流れ」として学び進めていただけますと幸いです。
01. ベルヌーイ分布
① 概要
確率分布の学習で最初に登場するのが、ベルヌーイ分布(Bernoulli distribution)です。これは、「1回の試行の結果が成功か失敗かのどちらか」という、もっともシンプルな確率の形を表します。
1回の試行をモデル化する
例えばコインを1回投げて表が出るか、裏が出るかという二拓の結果を表す確率変数 \(X\) を考えます。このとき、確率変数 \(X\) を次のように定義します。
\[
X =
\begin{cases}
1 & (成功:表が出た)\\[4pt]
0 & (失敗:裏が出た)
\end{cases}
\]
このように、「0か1か」だけの値をとる確率変数がしたがう分布をベルヌーイ分布と呼びます。成功する確率を \(p\) としたとき、この確率分布を次のように書きます。(“Bern” は “Bernoulli” の略です。)
\[
X \sim Bern(p)
\]
② 確率関数とグラフ
確率関数
ベルヌーイ分布の確率関数はとてもシンプルです。確率変数 \(X\) が「0(失敗)」か「1(成功)」のどちらかをとるとき、それぞれの確率は以下のように表されます。
\[
P(X=1)=p, \quad P(X=0)=1-p
\]
これを1つの式でまとめると以下のように書けます。
\[
P(X = x) = p^{x}(1 – p)^{1 – x} \quad (x = 0, 1)
\]
この1行の式がすぐれているのは、「 \(x\) の値によって自動的に正しい項が残る」という点です。具体的には以下のように整理されます。
\[\begin{align*}
x=1\text{のとき} &\rightarrow p^{1}(1 – p)^{0}=p\\[6pt]
x=0\text{のとき} &\rightarrow p^{0}(1 – p)^{1}=1-p
\end{align*}\]
グラフ
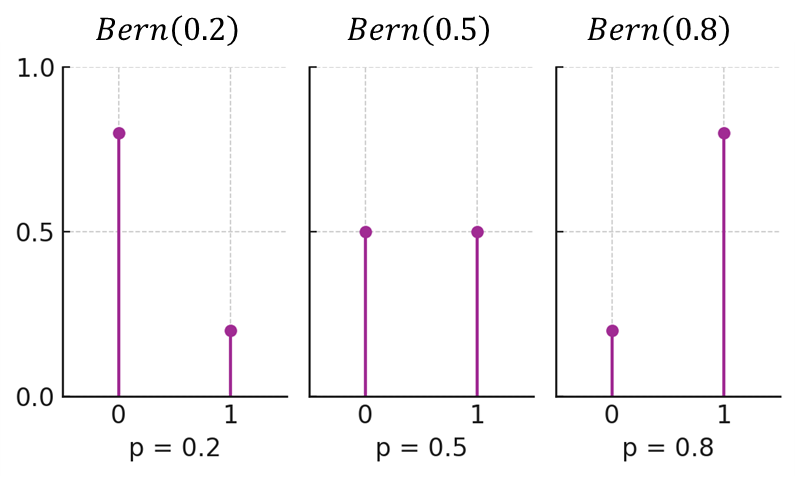
ベルヌーイ分布のグラフは「2本の棒」だけで表されます。 \(p\) が大きいほど、右側の棒(成功)が高く、左側の棒(失敗)が低くなります。
③ 期待値と分散
ここでは、前回までに学んだ「期待値」や「分散」の定義に従って、ベルヌーイ分布の場合の式を実際に計算してみましょう。
期待値の導出
期待値の定義は以下の通りでした。
\[
E[X] = \sum_x x\, P(X = x)
\]
ベルヌーイ分布では \(x\) は0または1しかとりません。したがって、次のように計算できます。
\[\begin{align*}
E[X] &= 0 \cdot P(X = 0) + 1 \cdot P(X = 1)\\[6pt]
&= 0 \cdot (1-p) + 1 \cdot p\\[6pt]
&=p
\end{align*}\]
分散の導出
分散については以下の公式を用いましょう。
\[
V[X] = E[X^{2}] – (E[X])^{2}
\]
ここで、ベルヌーイ分布においては \(X\) が0または1のため、2乗しても値が変化しません。つまり、 \(X^2=X\) なので、以下のように整理できます。
\[
E[X^{2}]=E[X]=p
\]
これを分散の公式に代入することで、以下のように導けます。
\[
V[X]=p-p^{2}=p(1-p)
\]
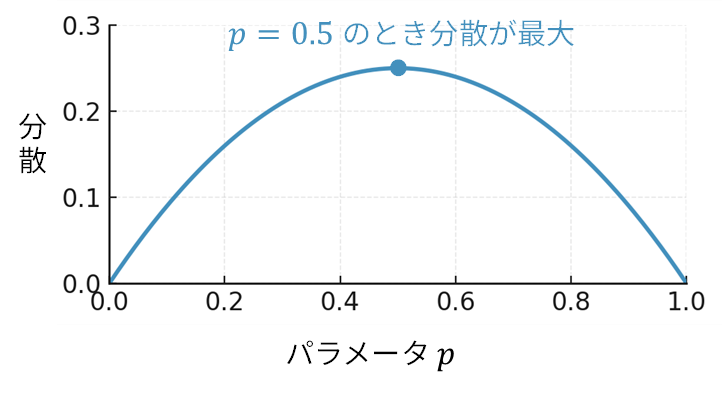
ベルヌーイ分布の分散 \(p(1-p)\) は、 \(p=0.5\) のときに成功と失敗が拮抗してばらつきが最大となります。逆に、 \(p\) が0や1に近づくほど、結果が固定され、分散は小さくなります。
④ 確率母関数
非負整数値をとる確率変数 \(X\) に対して、確率母関数は以下のように定義されます。
\[
G(s) = E[s^{X}] = \sum_{x=0}^{\infty} P(X = x)\, s^{x}
\]
ベルヌーイ分布 \(X \sim Bern(p)\) の場合、 \(X\) は 0 または 1 のどちらかしかとらないため、確率母関数は以下のようになります。
\[
G(s) = (1 – p)s^{0} + p s^{1} = 1 – p + p s
\]
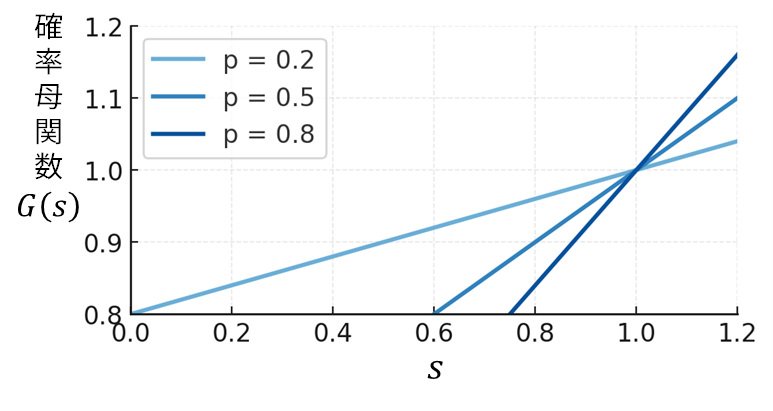
上記のようにベルヌーイ分布の確率母関数はシンプルな一次式(直線)となります。
確率母関数から期待値と分散を導く
ここで、先ほど確認した期待値と分散を、上記の確率母関数からも導出してみましょう。
まずおさらいですが、確率母関数の微分について以下のように整理できます。忘れてしまった場合は第02回「確率分布と確率母関数」の記事を見直してください。
\[\begin{align*}
G'(s) &= \bigl(E[s^{X}]\bigr)’ = E\!\left[X s^{\,X-1}\right]\\[4pt]
G^{\prime\prime}(s) &= E\!\left[X(X-1) s^{\,X-2}\right]
\end{align*}\]
この式に \(s=1\) を代入することで、 \(X\) の期待値、 \(X^2\) の期待値、 \(X\) の分散を以下のように整理できました。
\[\begin{align*}
&E\,[X]=G^{\prime}(1)\\[6pt]
&E\,[X^{2}]=G^{\prime\prime}(1)+G^{\prime}(1)\\[5pt]
&V\,[X]=G^{\prime\prime}(1)+G^{\prime}(1)-\bigl(G^{\prime}(1)\bigr)^{2}
\end{align*}\]
ここで、先ほどのベルヌーイ分布の確率母関数 \(G(s)=1-p+ps\) を微分すると以下のようになります。
\[\begin{align*}
&G^{\prime}(s)=p\\[6pt]
&G^{\prime\prime}(s)=0
\end{align*}\]
したがって、期待値と分散を以下のように導けます(先ほど求めた期待値と分散と一致していることが確認できます)。
\[\begin{align*}
&E\,[X]=p\\[6pt]
&V\,[X]=0+p-(p)^{2}=p(1-p)
\end{align*}\]
なお、ベルヌーイ分布の確率母関数( \(p=0.2,0.5,0.8\) )のグラフは以下のようになります。 \(p\) が大きいほど直線の傾き(それはすなわち「微分」が示すところ)が急になっています。
02. 二項分布
① 概要
前回のベルヌーイ分布では、1回の試行において「成功(1)」または「失敗(0)」となる結果を扱いました。これを \(n\) 回繰り返したとき、「成功が全部で何回起きるか」を表す分布が二項分布(Binomial distribution)です。
二項分布の考え方
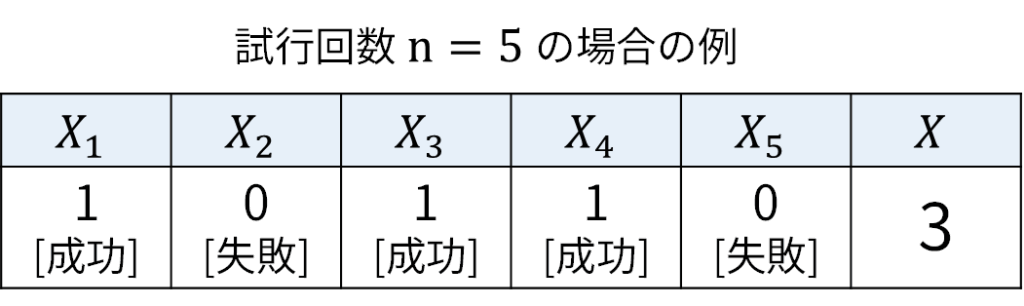
1回の試行で成功する確率を \(p\) 、失敗する確率を \(1-p\) とします。この試行を独立に \(n\) 回繰り返すと、結果は以下のような \(n\) 個のベルヌーイ変数の集まりになります。
\[
X_1,X_2,\dots ,X_n \sim Bern(p)
\]
そして、これらの合計を \(X\) とします。
\[
X=X_1+X_2+\cdots+X_n
\]
このとき「失敗(0)」は足しても0のままですので、合計 \(X\) は「 \(n\) 回のうち成功した回数」を表す確率変数となります。この成功回数 \(X\) が従う分布を二項分布と呼びます。
\[
X\sim Bin(n,p)
\]
② 確率関数とグラフ
二項分布の確率関数は以下の式で表されます。
\[
P(X = x) = \binom{n}{x} p^{x}(1 – p)^{n – x}, \quad (x = 0, 1, 2, \ldots, n)
\]
なお、 \(\binom{n}{x}\) は二項係数と呼ばれるもので、組み合わせの数(どの試行回で成功するかの通り数)を意味し、以下の式で計算されます。
\[
\binom{n}{x} = \dfrac{n!}{x!\,(n – x)!}
\]
例えば、 \(4\) 回中の \(2\) 回成功する場合の組み合わせの数は以下のように計算できます。
\[\begin{align*}
\binom{4}{2}&=\dfrac{4!}{2!\,(4-2)!}\\[6pt]
&=\dfrac{4 \times 3 \times 2\times 1}{2 \times 1 \times 2\times 1}\\[6pt]
&=\dfrac{4 \times 3}{2\times 1}\\[6pt]
&=6 \text{通り}
\end{align*}\]
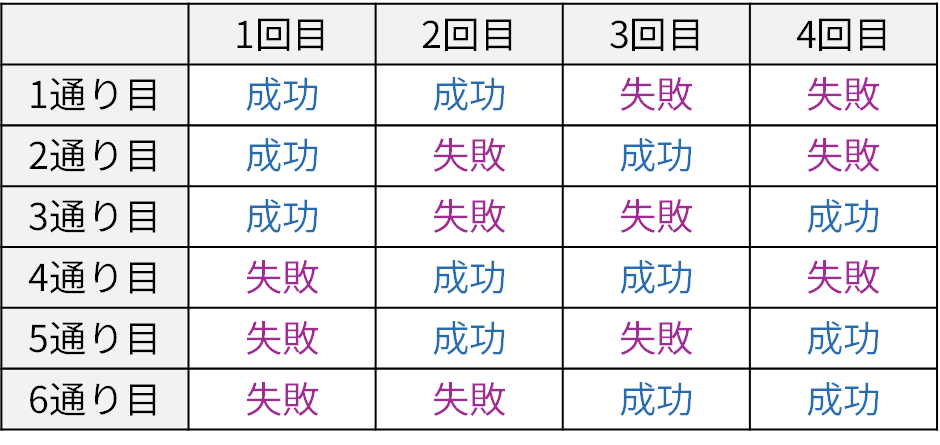
また、 \(p^{x}(1 – p)^{n – x}\) はある特定の成功・失敗パターンの確率を表します。例えば、 \(n\) 回中 \(3\) 回成功するパターンが生じる確率は \(p^{3}(1 – p)^{n – 3}\) となります。
つまり、二項分布の確率関数は、成功が \(x\) 回起きる組み合わせの数(二項係数)を、成功が \(x\) 回起きる確率に掛け合わせたものとなります。
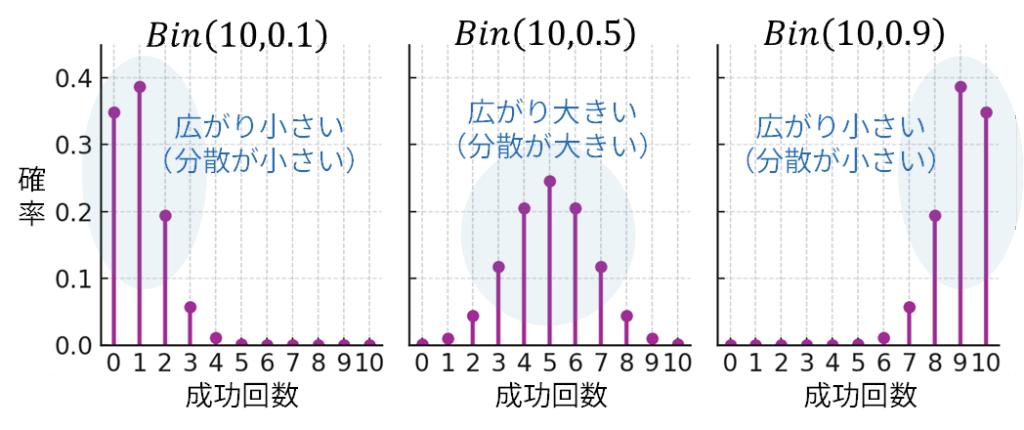
二項分布のグラフ
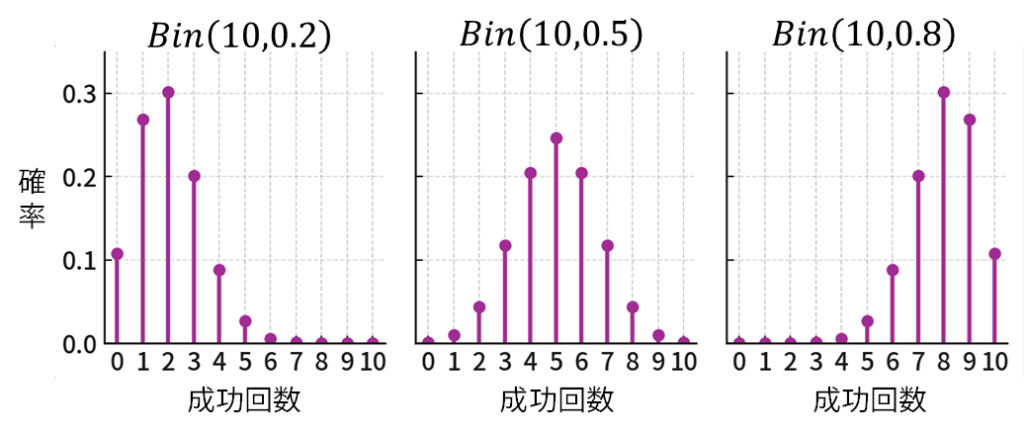
二項分布のグラフは成功確率 \(p\) が高いほどグラフは右側へ寄っていきます。これは成功しやすい試行であるほど、成功回数が多くなる確率が高くなるためです。
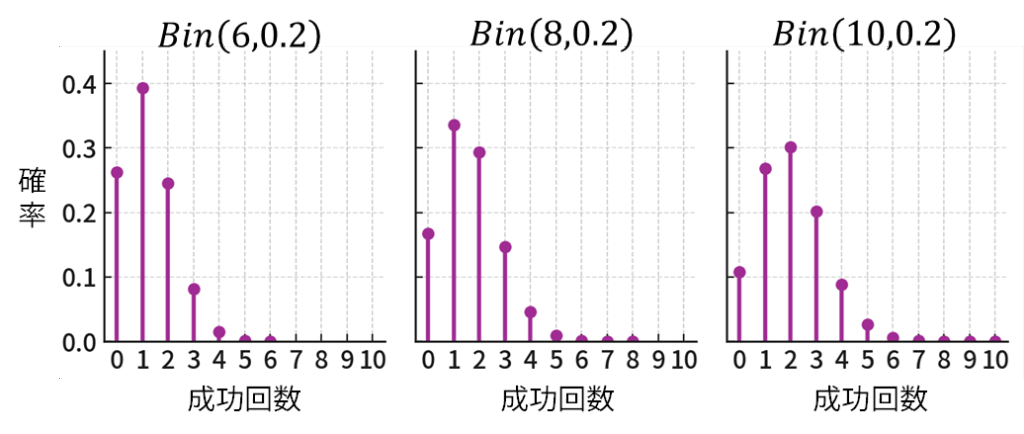
また、試行回数 \(n\) が多いほどグラフは右側へ寄っていきます。これも試行をたくさんすればするほど、成功回数が多くなる確率が高くなるためです。
③ 期待値と分散
期待値の導出
二項分布の期待値と分散は、ベルヌーイ分布を \(n\) 回足し合わせたという構造をもとに導くと、とてもシンプルになります。二項分布 \(X \sim Bin(n,p)\) は、以下のように表せます。なお、各 \(X_i\) は、独立なベルヌーイ分布 \(Bern(p)\) に従います。
\[
X = X_1 + X_2 + \cdots + X_n
\]
ここで期待値の線形性と、各 \(X_i\) の期待値はベルヌーイ分布より \(E[X_i] = p\) であることから、二項分布の期待値を以下のように導けます。
\[\begin{align*}
E[X] &= E[X_1] + E[X_2] + \cdots + E[X_n]\\[6pt]
&=np
\end{align*}\]
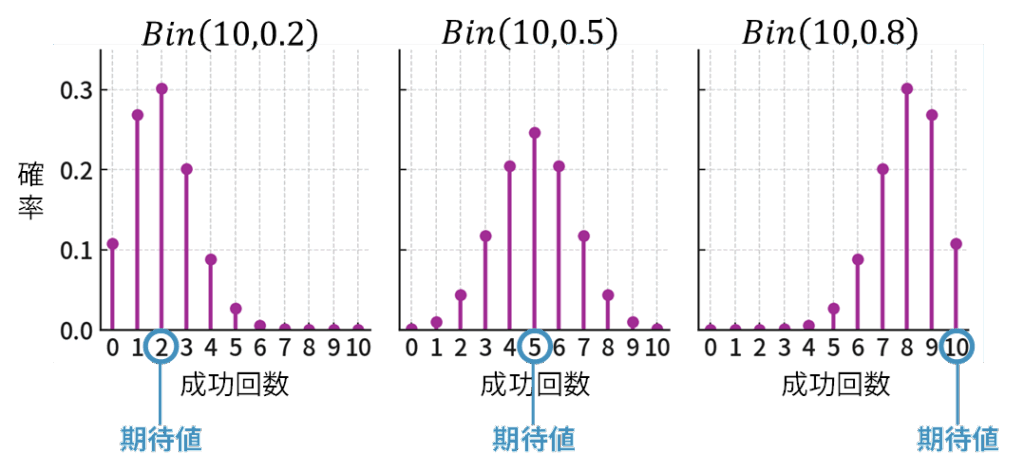
例えば、「成功確率 \(p=0.2\) の試行を \(n=10\) 回行ったときの成功回数の期待値」は、 \(np=10\times0.2=2\) 回となります。
分散の導出
分散も同様に、ベルヌーイ分布の性質を利用して求められます。それぞれの \(X_{i}\) は互いに独立で、ベルヌーイ分布の分散は \(V[X_{i}]=p(1-p)\) であることから、二項分布の分散を以下のように導けます。
\[\begin{align*}
V[X]&=V[X_1+X_2+\cdots+V[X_n]\\[6pt]
&=V[X_1]+V[X_2]+\cdots+V[X_n]\\[6pt]
&=np(1-p)
\end{align*}\]
④ 確率母関数
独立な和の母関数は、母関数の積
独立な確率変数 \(X\) と \(Y\) があるとき、その和 \(Z=X+Y\) の確率母関数は、それぞれの母関数の積になります(これも「第2回 確率分布と母関数」のおさらいです)。
\[
G_{Z}(s) = G_{X}(s)\,G_{Y}(s)
\]
なお、この性質は「独立であること」が前提条件であることに注意しましょう。
ベルヌーイ分布から二項分布へ
成功確率が \(p\) のベルヌーイ分布 \(X\sim Bern(p)\) の確率母関数は以下の通りでした。
\[
G(s) = 1 – p + p s
\]
二項分布は、「独立なベルヌーイ試行を \(n\) 回繰り返した結果」でした。それぞれのベルヌーイ試行を \(X_{i}\) とすると、その合計(成功回数) \(X\) が二項分布にしたがいます。
\[
X=X_1+X_2+\cdots +X_n
\]
つまり、二項分布は独立なベルヌーイ分布の和となりますので、先ほどの「独立な和の母関数は、母関数の積」という性質を利用して、「二項分布の確率母関数は、ベルヌーイ分布の確率母関数の積」として導くことができます。いま、二項分布の確率母関数を \(G_X(s)\) とし、ベルヌーイ分布の確率母関数を \(G_{X_{i}}(s)\) とすると、以下のように整理できます。
\[\begin{align*}
G_X(s)&=G_{X_1}(s)\;G_{X_2}(s)\cdots G_{X_n}(s)\\[6pt]
&=(1-p+ps)^{n}
\end{align*}\]
⑤ 論点1:再生性
「再生性」とは、「同じ型の分布をもつ確率変数を足し合わせても、その分布の型は変わらない」という性質を指します。二項分布やポアソン分布などで成立する一方で、指数分布など成立しない分布もあります。
二項分布の再生性のイメージ
例えば、次のような場面を考えてみましょう。
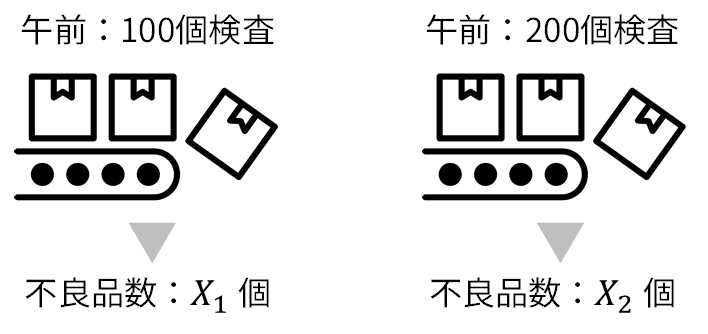
午前中の不良品数を \(X_1\) 、午後の不良品数を \(X_2\) とすれば、それぞれが次のような二項分布に従います。
\[
X_1 \sim Bin(100,\,0.05), \quad X_2 \sim Bin(200,\,0.05)
\]
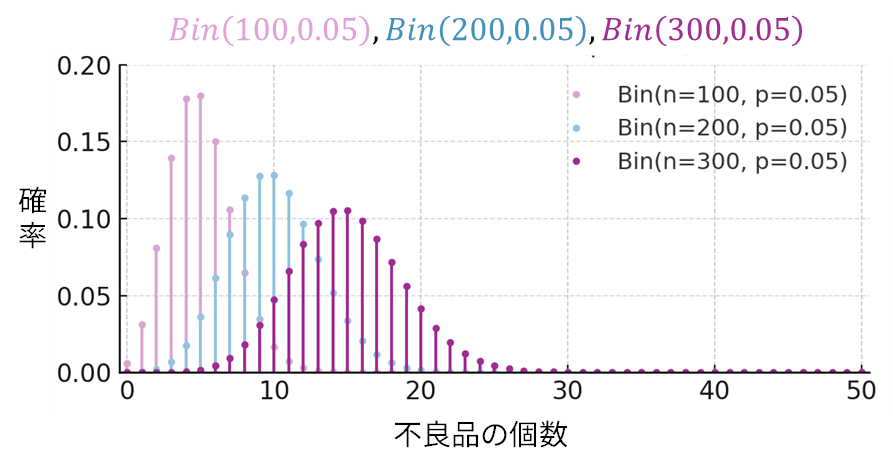
このとき、1日全体の不良品数 \(S = X_1 + X_2\) は、どんな分布に従うでしょうか?実は、この二項分布の和 \(S\) もまた二項分布に従います。
\[
S \sim Bin(100+200,0.05)
\]
確率母関数による証明
確率母関数を使うと、この関係をすぐに確認できます。午前と午後のそれぞれの確率母関数は以下の通りです。
\[
G_{X_1}(s) = (1-p+ps)^{100}, \quad G_{X_2}(s) = (1-p+ps)^{200}
\]
互いに独立な試行であるため、その和 \(S=X_1+X_2\) の確率母関数は、それぞれの確率母関数の積で表されます。
\[\begin{align*}
G_S(s) &= G_{X_1}(s)\;G_{X_2}(s)\\[6pt]
&= (1-p+ps)^{100}\,(1-p+ps)^{200}\\[6pt]
&= (1-p+ps)^{300}
\end{align*}\]
したがって、 \(S \sim Bin(300,p)\) となり、確かに二項分布の形がそのまま保たれる(=再生される)ことが確認できます。
03. 超幾何分布
① 概要
非復元抽出の確率
これまで扱ってきた二項分布では、各試行が独立でした。つまり、1回目の結果が2回目以降の確率に影響を与えない、いわゆる「復元抽出(取り出した後で戻す)」の設定でした。
一方、超幾何分布(Hypergeometric Distribution)は、復元しない抽出(取り出したら戻さない)、すなわち、「非復元抽出」のときの確率を表します。
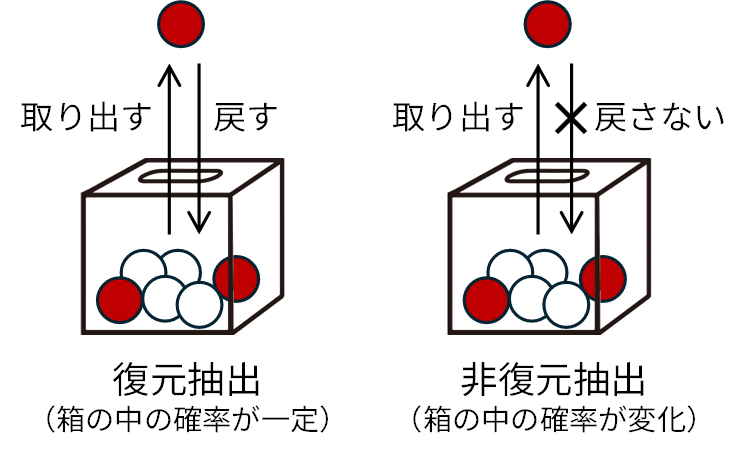
例えば以下のような場面を考えます。
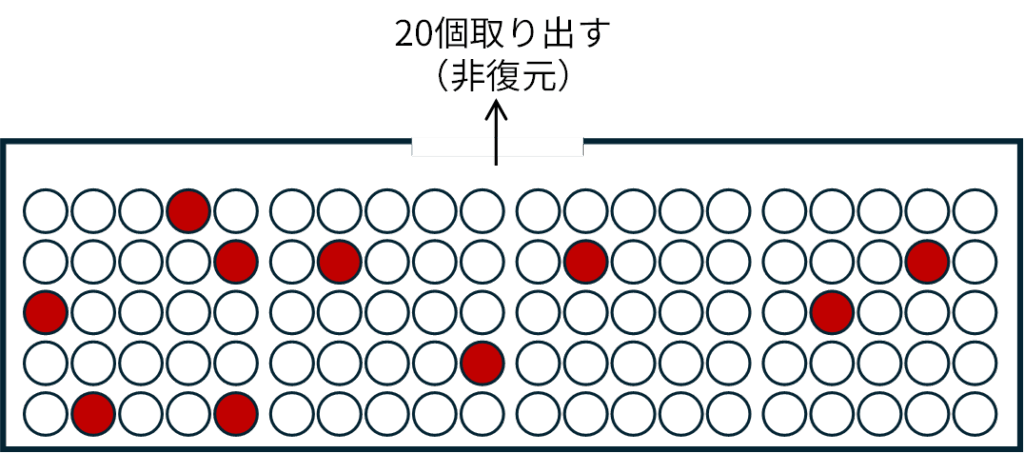
このように、母集団が有限で「戻さない」抽出では、試行が互いに独立ではなくなるため、二項分布(独立な試行という前提)では扱えません。ここで登場するのが超幾何分布です。
超幾何分布の定義
母集団の情報を以下のように整理します。
| 記号 | 意味 | 例 |
|---|---|---|
| \(N\) | 母集団の大きさ | 箱の中の総数 |
| \(M\) | 母集団の中の「成功」の個数 | 箱の中の赤玉の総数 |
| \(n\) | 抽出する個数 | 箱から取り出す個数 |
| \(X\) | 抽出した中の「成功」の個数 | 取り出された赤玉の数 |
このとき、確率変数 \(X\) は超幾何分布にしたがい、以下のように表記します。
\[
X\sim HG\,(N,\,M,\,n)
\]
二項分布とのちがい
先ほどの例において、仮に以下のように「復元抽出」により玉を抽出する場合は、それぞれの試行は互いに独立(赤玉が抽出される確率が一定)なものとなります。
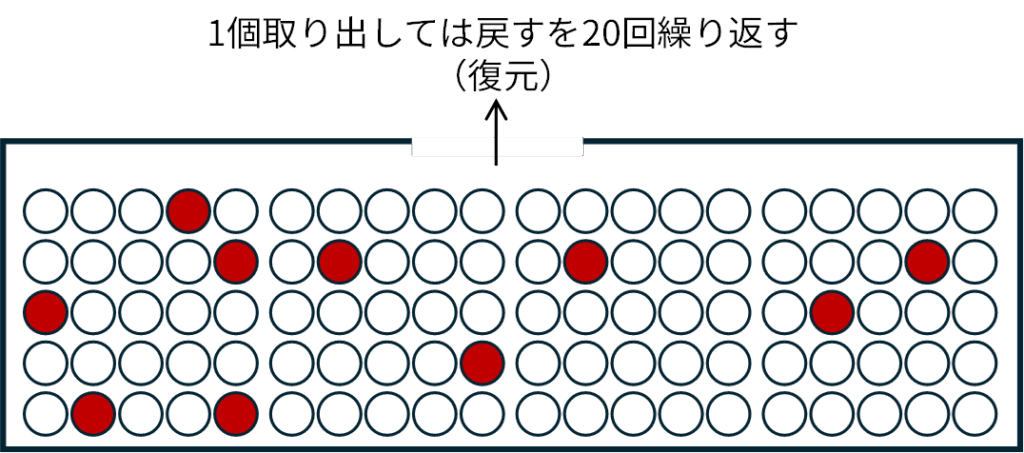
上記のような「復元抽出」の場合、赤玉が抽出される確率は \(p=10/100\) で常に一定となり、抽出される赤玉の個数は二項分布 \(Bin(100,10/100)\) にしたがうことになります。以下で二項分布と超幾何分布のちがいを整理しておきましょう。
| 項目 | 二項分布 | 超幾何分布 |
|---|---|---|
| 抽出のしかた | 復元抽出(戻す) | 非復元抽出(戻さない) |
| 試行の独立性 | 独立 | 従属(確率が変化) |
| パラメータ | \(n, p\,(=M/N\,)\) | \(N, M, n\) |
| 成功確率 | \(p\) で一定 | 抽出のたびに変化 |
② 確率関数とグラフ
超幾何分布 \(X\sim HG(N,M,n)\) の確率関数は以下の式で表されます。
\[
P(X = x) =\dfrac{\binom{M}{x}\, \binom{N \, – \, M}{n \, – \, x}}{\binom{N}{n}}, \quad (x = 0, 1, 2, \ldots, n)
\]
超幾何分布の確率関数は上記の通り3つの二項係数が登場します。それぞれの意味を以下に整理しておきます。
| 二項係数 | 意味 |
|---|---|
| \(\binom{M}{x}\) | 母集団中の「成功」\(M\) 個から、 \(x\) 個を選ぶ組み合わせ数 |
| \(\binom{N-M}{n-x}\) | 母集団中の「失敗」\(N-M\) 個から、残り \(n-x\) 個を選ぶ組み合わせ数 |
| \(\binom{N}{n}\) | 全体から \(n\) 個を選ぶ組み合わせ数(すべての組み合わせ数) |
この式は、母集団から \(n\) 個抽出したときに「 \(n\) 個中に成功が \(x\) 個(失敗が \(n-x\) 個)含まれる組み合わせ数」(分子)と、「ありうる \(n\) 個の全組み合わせ数」(分母)の比として表したものと言えます。
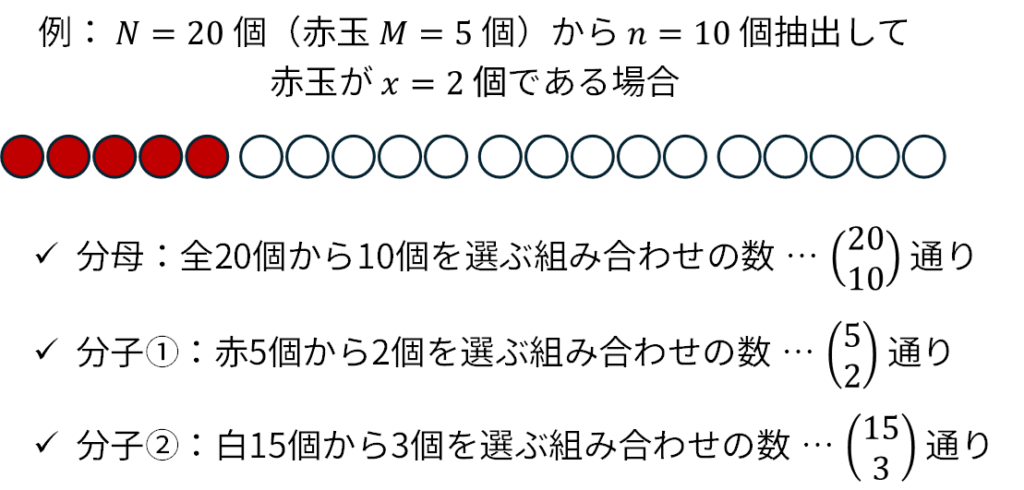
なおこのとき、 \(x\) のとりうる範囲は以下のようになります。
\[
\max(0,\, n – (N – M)) \le x \le \min(n,\, M)
\]
\(\max(0,\, n – (N – M))\) はカッコ内の値のうち最大のものを示し、ここでは、 \(0\) と \(n-(N-M)\) のうち大きい方の値となります。また、 \(\min(n,\, M)\) はカッコ内の値のうちの最小のものを示し、ここでは、 \(n\) と \(M\) のうち小さい方の値となります。
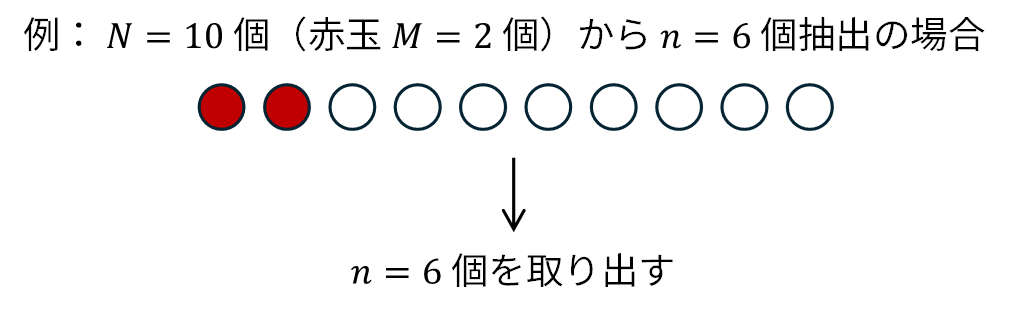
例えば、超幾何分布 \(X\sim HG(10,2,6)\) の場合を考えてみます。このとき、赤玉は \(M=2\) 個しかありませんので、\(n=6\) 個抽出したうちの赤玉の個数 \(x\) は最大でも \(2\) 個となります。このように、母集団の成功(赤玉)数 \(M\) や母集団から抽出する数 \(n\) によって、 \(x\) の上限・下限が制約される点に注意しましょう。
③ 期待値と分散
期待値
超幾何分布 \(X \sim HG(N,M,n)\) の期待値は次の式で表されます。
\[
E[X] = n\, \dfrac{M}{N}
\]
この式は、二項分布の期待値 \(np\) における \(p\) を \(M/N\) とおきかえたもので、「非復元抽出による確率の揺らぎはあるものの平均すると最初の比率に戻る」という性質を表しています。以下でその考え方を見ていきましょう。
期待値の導出
ここで、 \(i\) 番目に抽出した玉についての確率変数を \(X_{i}\) とします。 \(X_{i}\) は \(i\) 番目に抽出した玉が赤玉(成功)であるときに \(1\) 、白玉(失敗)であるときに \(0\) をとるものとします。 そうすると、抽出総数 \(n\) 個のうちの赤玉の個数 \(X\) を以下のように \(X_{i}\) の合計として表せます。
\[
X=X_{1}+X_{2}+\cdots +X_{n}
\]
したがって、期待値の線形性より、求めたい赤玉個数(成功数) \(X\) の期待値を以下のように \(X_{i}\) を用いて整理できます。
\[
E[X] = E[X_1] + E[X_2] + \cdots + E[X_n]
\]
ここで、1番目の玉ではまだ何も抽出されていない状態ですので、 \(X_{1}\) の期待値は以下のようになります。
\[\begin{align*}
E[X_{i}]&=P(X_{1}=0)\times 0 + P(X_{1}=1)\times 1\\[6pt]
&=0+\dfrac{M}{N}\times 1\\[6pt]
&=\dfrac{M}{N}
\end{align*}\]
続いて、2番目の \(X_{2}\) の期待値は、1番目が赤玉か白玉かで「(2番目の)赤玉抽出確率」が変化しますので、場合分けして導く必要があります。具体的には、「1番目赤玉かつ2番目赤玉の確率」と「1番目白玉かつ2番目赤玉の確率」の和として、以下のように導けます。
\[\begin{align*}
E[X_{2}] &= (\text{1番目赤玉かつ2番目赤玉の確率})\\[2pt]
&\quad + (\text{1番目白玉かつ2番目赤玉の確率})\\[8pt]
&= \dfrac{M}{N} \cdot \dfrac{M – 1}{N – 1} + \dfrac{N – M}{N} \cdot \dfrac{M}{N – 1}\\[8pt]
&= \dfrac{M(M-1)}{N(N-1)} + \dfrac{(N – M)M}{N(N-1)}\\[8pt]
&= \dfrac{(M^{2} – M) + (NM – M^{2})}{N(N-1)}\\[8pt]
&= \dfrac{-M+NM}{N(N-1)}\\[8pt]
&= \dfrac{M(N-1)}{N(N-1)}\\[8pt]
&= \dfrac{M}{N}
\end{align*}\]
このように、1番目から場合分けして確率をたどっていくと、2番目の \(X_2\) の期待値も \(M/N\) となるのです。これは3番目以降も同様で、それぞれの \(E[X_{i}]\) は結局は \(M/N\) となります。
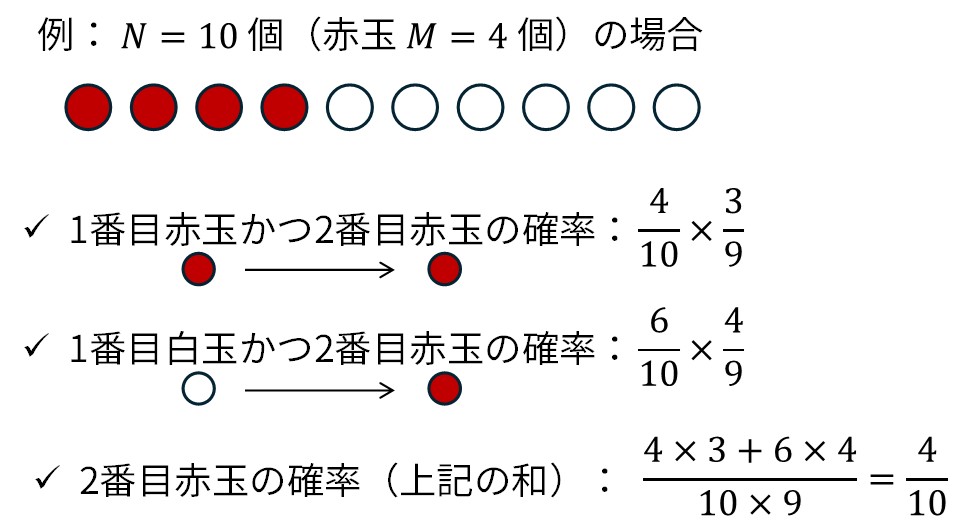
したがって、求めたい \(E[X]\) を以下のように整理できます。
\[\begin{align*}
E[X] &= E[X_1] + E[X_2] + \cdots + E[X_n]\\[6pt]
&=\dfrac{M}{N} + \dfrac{M}{N} + \cdots + \dfrac{M}{N}\\[6pt]
&=n \, \dfrac{M}{N}
\end{align*}\]
分散
超幾何分布 \(X\sim HG(N,M,n)\) の分散は以下の式になります。なお、2行目の式は \(M/N\) を二項分布の成功確率 \(p\) で置き換えたものです。
\[\begin{align*}
V[X] &= n \, \dfrac{M}{N} \left(1 – \frac{M}{N}\right) \dfrac{N – n}{N – 1}\\[10pt]
&= n p (1-p) \,\dfrac{N-n}{N-1}
\end{align*}\]
証明はやや複雑なので別の記事に譲らせていただきます。ポイントは、二項分布 \(Bin(n,p)\) の分散 \(np(1-p)\) に、 \(\dfrac{N-n}{N-1}\) が掛かっている形になっているという点です。この \(\dfrac{N-n}{N-1}\) のことを「有限母集団修正係数」と呼びます(後述)。
これは、非復元抽出(戻さない)ゆえに試行同士がわずかに影響し合い、分布が少しだけ「抑制される」(=ばらつきが小さくなる)とイメージしておくとよいでしょう。
分散が「抑制される」イメージ
例えば、母集団が \(N=10\) 個、そのうち赤玉が \(M=4\) 個、白玉が \(N-M=6\) 個とします。赤玉の割合は \(p=M/N=0.4\) です。ここから非復元抽出により \(n=5\) 個抽出するものとします。
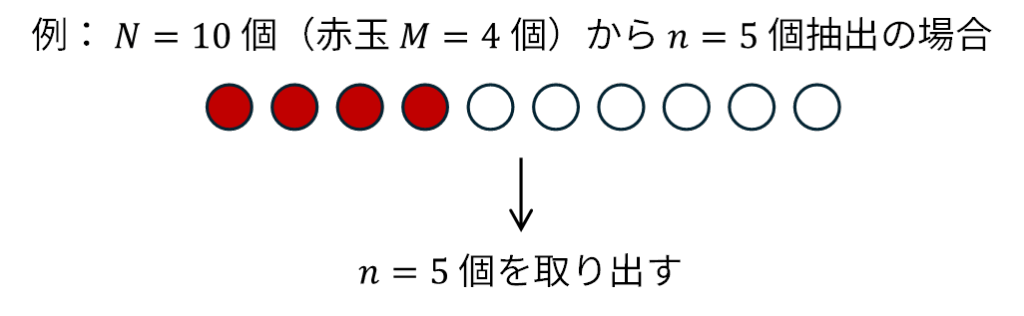
復元抽出の場合(二項分布 \(Bin(5,0.4)\) )
各回の赤玉抽出確率は常に \(p=0.4\) なので、 \(n=5\) 回の結果は独立しています。その結果、赤玉の出方は「偏る」こともあり、\(X\) は \(0\sim5\) に確率が比較的満遍なく散らばります(5回中5回とも赤玉、あるいは赤玉が0回ということも十分あり得る、ということです)。
非復元抽出の場合(超幾何分布 \(HG(10,4,5)\) )
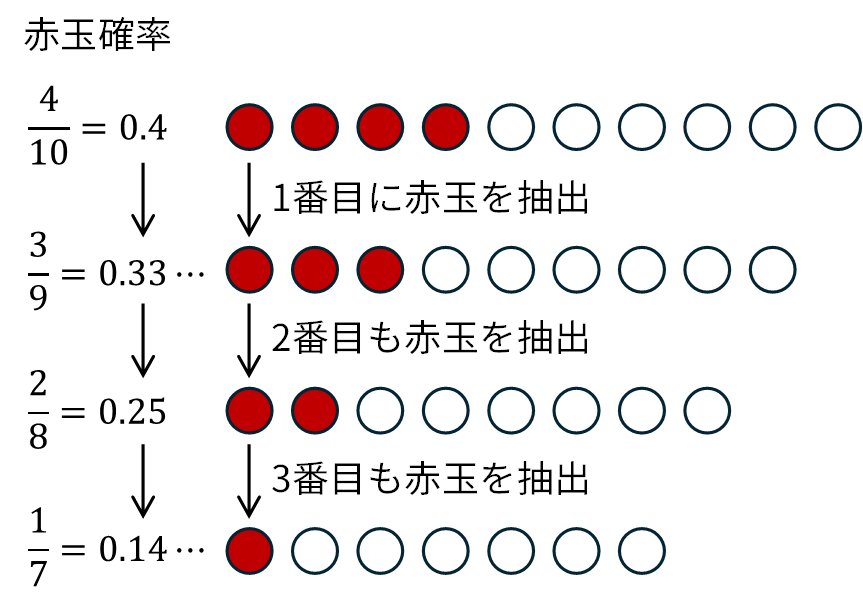
赤玉を抽出したら箱の中の赤玉が減り、その後の赤玉抽出確率は下がります。また、白玉を抽出したら箱の中の赤玉比率が上がり、その後の赤玉抽出確率が上がります。 結果として、極端に偏った状態が生じづらくなります。
例えば、最初に赤玉を連続で3個抽出したら、箱の中の残りは赤玉1個・白玉6個になります。もうそこから「さらに赤を抽出する」ことが難しくなります。逆に白玉ばかり引いたら、残りは赤玉が多くなり、次は赤玉が出やすくなります。この結果として、非復元抽出の場合の赤玉抽出個数 \(X\) の分散は抑制されることになるのです。
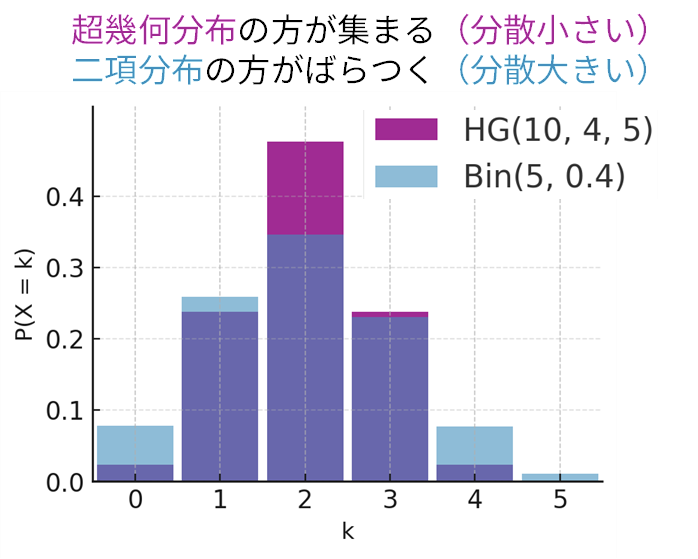
実際に両者の確率分布を並べたものが以下のグラフです。超幾何分布のグラフの方がやや中央に集まっており、分散が抑制されていることがわかります。
④ 確率母関数
二項分布の確率母関数は以下のシンプルな式で表されました。これは「独立なベルヌーイ分布の和」という構造がそのまま式に反映されたものです。
\[
G(s) = (1-p+ps)^n
\]
一方で、超幾何分布 \(HG(N,M,n)\) の確率母関数は次のように表されます。
\[\begin{align*}
G(s) = \sum_{x = 0}^{n} \dfrac{\binom{M}{x}\, \binom{N – M}{n – x}}{\binom{N}{n}}\, s^{x}
\end{align*}\]
この式は確率母関数の定義式に、確率関数を形式的に代入しただけのものです。これを展開したいところですが、超幾何分布は非復元抽出による非独立性により、結局「すべての組合せを足し合わせる」式(ガウスの超幾何関数)を用いるしかありません。準1級対策としては深入りする必要はありません。
⑤ 論点1:二項分布への近似
超幾何分布は非復元抽出を前提としていますが、抽出率 \(n/N\) が十分に小さいとき、「戻さない」ことの影響がほとんど無視できるようになります。そのため、超幾何分布 \(HG(N,M,n)\) は、同じ成功確率 \(p=M/N\) の二項分布 \(Bin(n,p)\) でよく近似できます。
\[
HG(N, M, n) \approx Bin(n, p), \quad p = \dfrac{M}{N}
\]
ただし、この近似が成立するのは、以下の場合に限ります。
\[
\dfrac{n}{N} \ll 1
\]
すなわち「母集団 \(N\) に比べて標本 \(n\) が小さい」場合に、超幾何分布は二項分布に近似します。
直感的イメージ
非復元抽出では、赤を引くたびに赤の割合が微妙に減ります。しかし \(N\) が大きく、 \(n\) がその一部にすぎないなら、 \(n\) 回引いたくらいでは箱の中身がほとんど変わりません。つまり、非復元抽出ではあるものの「毎回同じ確率 \(p\) で独立に引いている」と見なせるのです。このとき、試行の独立性が近似的に「復活」し、二項分布によく近似することになります。
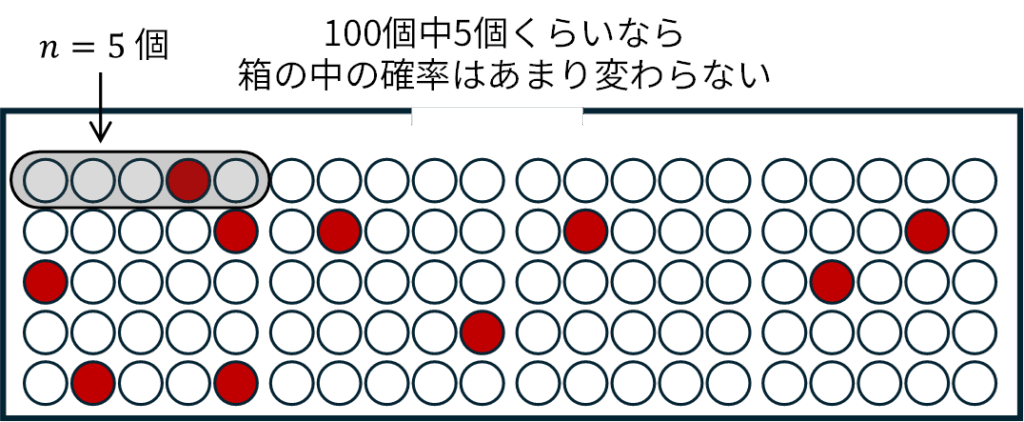
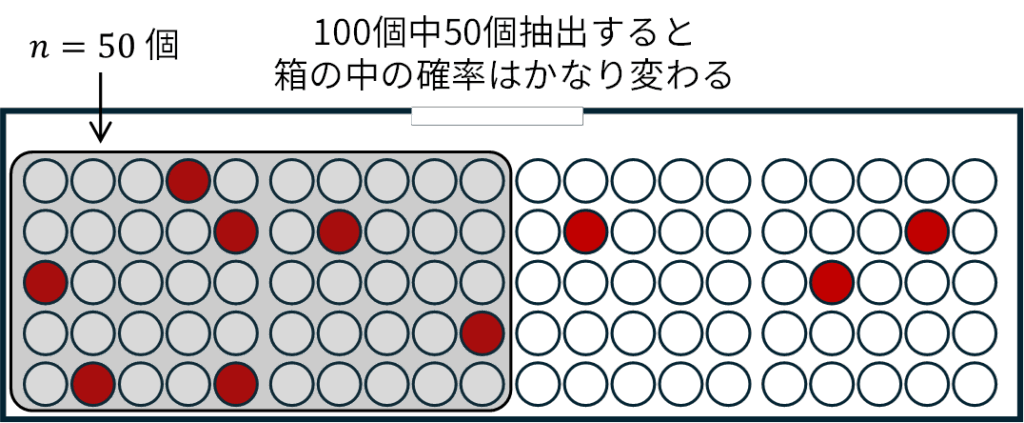
グラフで確認する
実際に抽出率の異なる3つの超幾何分布(いずれも \(n=10\) で \(p=0.2\) )のグラフ(紫色)を、それぞれ、二項分布 \(Bin(10,0.2)\) のグラフ(水色)に重ねて描画してみます。
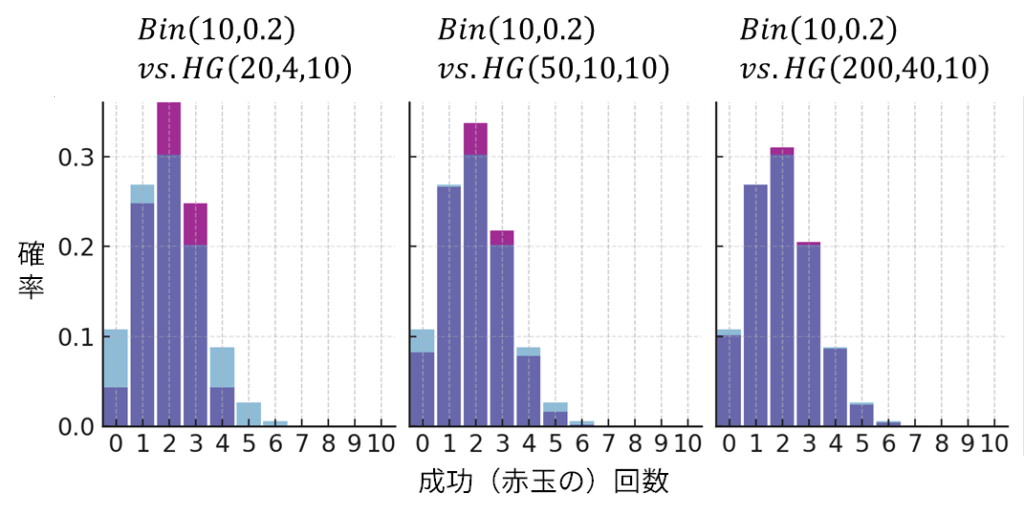
抽出率が \(n/N=0.5\) のとき(左図)には超幾何分布と二項分布には明確な差を確認できますが、抽出率が \(n/N=0.2\) (中央図)、 \(n/N=0.05\) (右図)と小さくなるにつれて、両者の分布がよく近似していく様子を確認できます。
分散の視点(有限母集団修正係数)
これは超幾何分布の分散の式からも確認できます。超幾何分布の分散は以下の式でした。
\[\begin{align*}
V[X] &= n \, \dfrac{M}{N} \left(1 – \frac{M}{N}\right) \dfrac{N – n}{N – 1}\\[10pt]
&= n p (1-p) \,\dfrac{N-n}{N-1}
\end{align*}\]
この式の最後にある \(\dfrac{N-n}{N-1}\) を「有限母集団修正係数」と呼びます。これは、母集団が有限であることによって分散がやや小さくなる補正です。
抽出率 \(n/N\) が小さいとき、この係数は \(1\) に近づき、有限母集団の影響はほとんど消えます。つまり、母集団が非常に大きければ、非復元抽出でも実質的に「無限母集団」とみなせ、分散は二項分布の式 \(np(1-p)\) に近づくのです。
つまり、有限母集団修正とは、「母集団の”有限さ”がもたらす分散の縮み」を補正するための係数であり、抽出率 \(n/N\) が小さいときは \(1\) に近づき、結果的にこのとき超幾何分布は二項分布へと近似されます。
04. ポアソン分布
① 概要
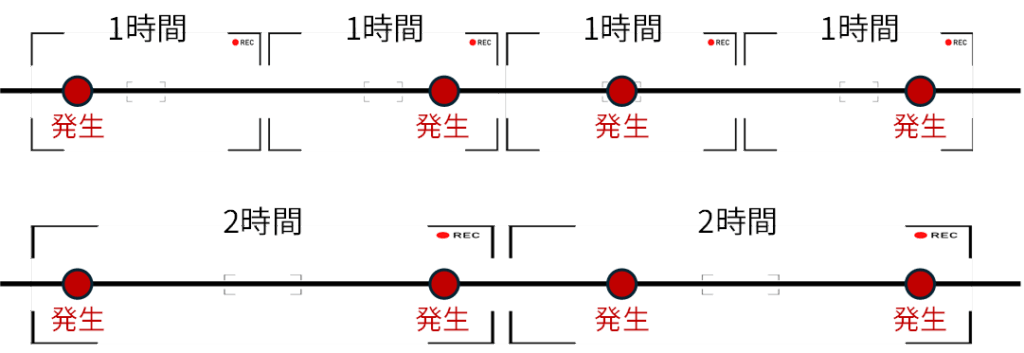
ポアソン分布は、一定の区間の中で起こる独立な事象の回数を表す離散分布です。ここでいう「区間」は、時間・空間・面積など、観測の対象を区切った枠を意味します。例えば、以下のような「数」について考えます。
- 「1時間あたりの電話の着信件数」
- 「1日あたりの交通事故の発生件数」
- 「1kmの道路にある落下物の個数」
- 「1cm²の基板上に発生する欠陥の数」
これらはいずれも、ある決まった範囲の中で「いくつ起きたか」を数えている点で共通しています。それを数える範囲を意識することがポアソン分布の理解にはとても重要で、この「観測の範囲」を「観測枠」と呼ぶことにします。
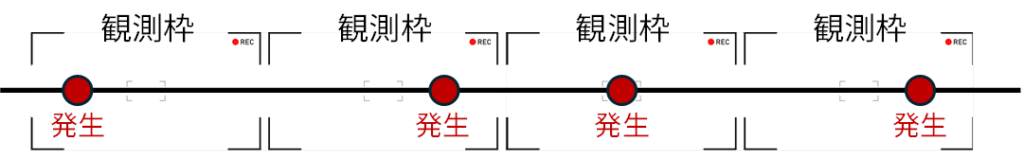
仮に観測枠を1時間から2時間に広げれば、件数の平均もおおよそ2倍になります。また、観測枠を1kmから半分の0.5kmにすれば、件数の平均もおおよそ半分になります。つまり、「観測枠」はどのくらいの範囲で数えるかを決める「カウントの器」と考えるとよいでしょう。この「器」が大きくなれば件数も増え、小さくなれば減ります。ポアソン分布では、この「枠の大きさ」に応じて平均件数が比例的に変化します。
パラメータと記号
観測枠内における発生件数を \(X\) とし、観測枠あたりの平均発生件数を \(\lambda \, (\lambda > 0)\) とすると、 \(X\) はパラメータ \(\lambda\) のポアソン分布にしたがい、これを以下のように表記します。
\[
X \sim Po(\lambda)
\]
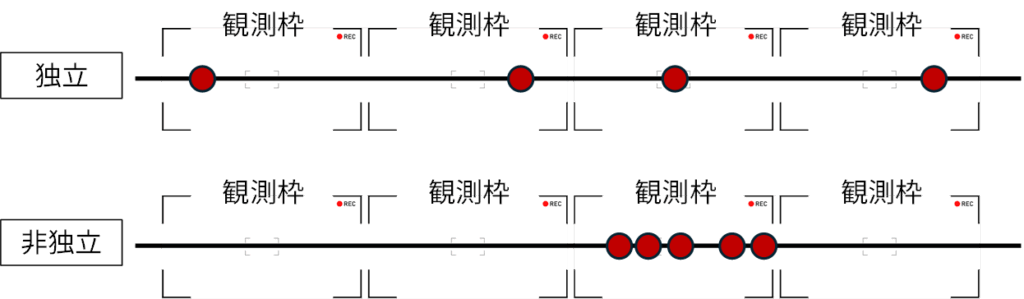
例えば、1時間あたり平均5件の着信がある場合、「1時間に起きる着信の件数 \(X\) 」は \(\lambda=5\) のポアソン分布にしたがいます。ただし、これは着信どうしが独立に発生し、かつ、時間帯によって発生率が大きく変わらないという前提があるときに成り立ちます。
つまり、「特定の時間帯に集中する」「1本の電話が次の電話を誘発する」ような場合は、この単純なポアソンモデルではうまく説明できません。一方で、1件1件が偶然に、独立に、平均的に一定のペースで発生するような現象では、このモデルは非常によく当てはまります。
② 確率関数とグラフ
観測枠あたりの平均発生数を \(\lambda>0\) とすると、ポアソン分布 \(X\sim Po(\lambda)\) の確率関数は以下のような式になります。
\[\begin{align*}
P(X = x) = \dfrac{e^{-\lambda} \lambda^{x}}{x!}, \quad (x = 0, 1, 2, \ldots)
\end{align*}\]
例えば、平均発生数 \(\lambda=1\) のポアソン分布にしたがう確率変数 \(X\) が、\(X=0,1,2\) となるそれぞれの確率を以下のように計算できます。
\[\begin{align*}
P(X = 0) &= \dfrac{e^{-1} \, 1^{0}}{0!} = e^{-1} \approx 0.3679 \\[6pt]
P(X = 1) &= \dfrac{e^{-1} \, 1^{1}}{1!} = e^{-1} \approx 0.3679 \\[6pt]
P(X = 2) &= \dfrac{e^{-1} \, 1^{2}}{2!} = \dfrac{e^{-1}}{2} \approx 0.1839
\end{align*}\]
確率関数の導出(二項分布から)
ポアソン分布の確率関数は二項分布から導出されます。ポアソン分布と二項分布の関係については後ほど詳しく見ていくこととして、ここでは式の導出について確認しておきましょう。※準1級レベルではこの導出は飛ばしていただいても大丈夫ですが、「まとめ」の内容についてはおさえておいてください。
二項分布 \(X\sim Bin(n,p)\) の確率関数は以下の通りでした。
\[
P(X = x)
= \binom{n}{x} p^{x} (1 – p)^{n – x}
\]
ここで、計算の工夫のため \(np=\lambda\) 、すなわち、 \(p=\lambda/n\) として上記式を以下のように整理します。なお、 \(\lambda > 0\) (一定)とします。
\[\begin{align*}
P(X = x) &= \binom{n}{x} p^{x} (1 – p)^{n – x}\\[10pt]
&= \underbrace{\binom{n}{x}\left(\frac{\lambda}{n}\right)^{x}}_{(A)} \;
\underbrace{\left(1 – \frac{\lambda}{n}\right)^{n – x}}_{(B)}
\end{align*}\]
上記の式を前半部分 \((A)\) と後半部分 \((B)\) に分けて整理する点がポイントで、この式の \((A)\) と \((B)\) について、別々に、極限 \((n\rightarrow \infty)\) を評価していきます。まずは、\((A)\) について整理します。
\[\begin{align*}
(A) &= \binom{n}{x} \left(\dfrac{\lambda}{n}\right)^{x} \\[10pt]
&= \dfrac{\overbrace{n (n – 1) \cdots (n – x + 1)}^{x\text{個}}}{x!} \left(\dfrac{\lambda}{n}\right)^{x} \\[10pt]
&= \dfrac{\lambda^{x}}{x!} \left( \dfrac{ n (n – 1) \cdots (n – x + 1)}{n^{x}} \right) \\[10pt]
&= \dfrac{\lambda^{x}}{x!} \underbrace{\left( \dfrac{ n (n – 1) \cdots (n – x + 1)}{n \cdot n \cdots n} \right)}_{\text{分母も分子も}\,x\,\text{個}} \\[10pt]
&= \dfrac{\lambda^{x}}{x!} \left(1 \right)\!\left(1 – \frac{1}{n}\right)\!\left(1 – \frac{2}{n}\right)\!\cdots\!\left(1 – \frac{x – 1}{n}\right)\\[10pt]
&= \dfrac{\lambda^{x}}{x!} \prod_{k = 0}^{x – 1} \left(1 – \dfrac{k}{n}\right)
\end{align*}\]
ここで、 \((1-\dfrac{k}{n})\) は極限( \(n\rightarrow \infty\) )をとると \(1\) となりますので、 \((A)\) の極限を以下のように整理できます。
\[\begin{align*}
(A)&=\dfrac{\lambda^{x}}{x!} \prod_{k = 0}^{x – 1} \left(1 – \dfrac{k}{n}\right)\\[10pt]
&\longrightarrow \dfrac{\lambda^{x}}{x!} \quad (n \to \infty)
\end{align*}\]
続いて \((B)\) の極限についてみていきましょう。
\[\begin{align*}
(B) &= \left(1 – \dfrac{\lambda}{n}\right)^{n – x} \\[10pt]
&=\underbrace{\left(1 – \dfrac{\lambda}{n}\right)^{n}}_{(B1)} \;
\underbrace{\left(1 – \dfrac{\lambda}{n}\right)^{-x}}_{(B2)}
\end{align*}\]
ここで、 \((B2)\) の項は極限( \(n \rightarrow \infty\) )をとると \((B2)\rightarrow 1\) となるため、 \((B)\) の極限における本質的な部分は \((B1)\) の項となります。この \((B1)\) の極限を考えるためには、以下のテイラー展開(マクローリン展開)を利用します。
\[\begin{align*}
\log(1 – u)
= &-u \, – \dfrac{u^{2}}{2} \, – \dfrac{u^{3}}{3} \, – \cdots\\[6pt]
&\quad (\text{収束域 } |u| < 1)
\end{align*}\]
これを \(u=\dfrac{\lambda}{n}\) に適用すると( \(n\) が大きければ \(|u|<1\) )
\[
\log\left(1 – \dfrac{\lambda}{n}\right)
= -\dfrac{\lambda}{n}
– \dfrac{1}{2} \left(\dfrac{\lambda}{n}\right)^{2}
– \dfrac{1}{3} \left(\dfrac{\lambda}{n}\right)^{3}
– \cdots
\]
両辺に \(n\) を掛けると、その極限 \(( n\rightarrow \infty)\) が以下のように \(-\lambda\) となることを導けます。
\[\begin{align*}
n \log\!\left(1 – \dfrac{\lambda}{n}\right) &= -\lambda
\; – \dfrac{\lambda^{2}}{2n}
\; – \dfrac{\lambda^{3}}{3n^{2}}
\; – \cdots\\[10pt]
&\longrightarrow\; -\lambda \quad (n \to \infty)
\end{align*}\]
ここで、 \((B1)\) を指数と対数で表現すると( \(e\) の \(\log M\) 乗は \(M\) 、つまり、 \(\exp \left( \log M \right) =M\) であることに注意して)、上記を踏まえて極限を以下のように導けます。
\[\begin{align*}
\left(1 – \dfrac{\lambda}{n}\right)^{n}
&= \exp\left\{ \, \log \; \left(1 – \dfrac{\lambda}{n}\right)^{n} \right\}\\[10pt]
&= \exp\left\{ \, n \log \; \left(1 – \dfrac{\lambda}{n}\right) \right\}\\[10pt]
&\longrightarrow\; e^{-\lambda} \quad (n \to \infty)
\end{align*}\]
以上より、 \((B)\) の極限を以下のように導けます。
\[\begin{align*}
(B) &= \left(1 – \dfrac{\lambda}{n}\right)^{n – x} \\[10pt]
&=\underbrace{\left(1 – \dfrac{\lambda}{n}\right)^{n}}_{(B1)} \;
\underbrace{\left(1 – \dfrac{\lambda}{n}\right)^{-x}}_{(B2)}\\[10pt]
&\longrightarrow \; e^{-\lambda}\times 1=e^{-\lambda} \quad (n \to \infty)
\end{align*}\]
以上より、ポアソン分布の確率関数を、二項分布の確率関数 \(P(X=x)\) の極限として、以下のように導けます。
\[\begin{align*}
P(X = x) &= \binom{n}{x} p^{x} (1 – p)^{n – x}\\[10pt]
&= \underbrace{\binom{n}{x}\left(\frac{\lambda}{n}\right)^{x}}_{(A)} \;
\underbrace{\left(1 – \frac{\lambda}{n}\right)^{n – x}}_{(B)}\\[10pt]
&\longrightarrow \; \dfrac{\lambda^{x}}{x!} \times e^{-\lambda} = \dfrac{e^{-\lambda} \lambda^{x}}{x!}
\end{align*}\]
まとめ
以上の導出から分かるように、
\[
p = \dfrac{\lambda}{n}, \quad np = \lambda \text{(一定)}
\]
という条件のもとで、極限 \(n \to \infty\) をとったときに導かれる式が、まさにポアソン分布の確率関数です。
\[
P(X = x) = e^{-\lambda} \dfrac{\lambda^{x}}{x!}
\]
言い換えれば、二項分布において「成功確率 \(p\) が極めて小さいが、試行回数 \(n\) は極めて大きい」状況では、二項分布はポアソン分布に近似できるということです。つまり、二項分布の「まれな成功」の世界の極限を考えた分布が、ポアソン分布なのです。イメージの参考までに、以下に例を2つあげておきます。
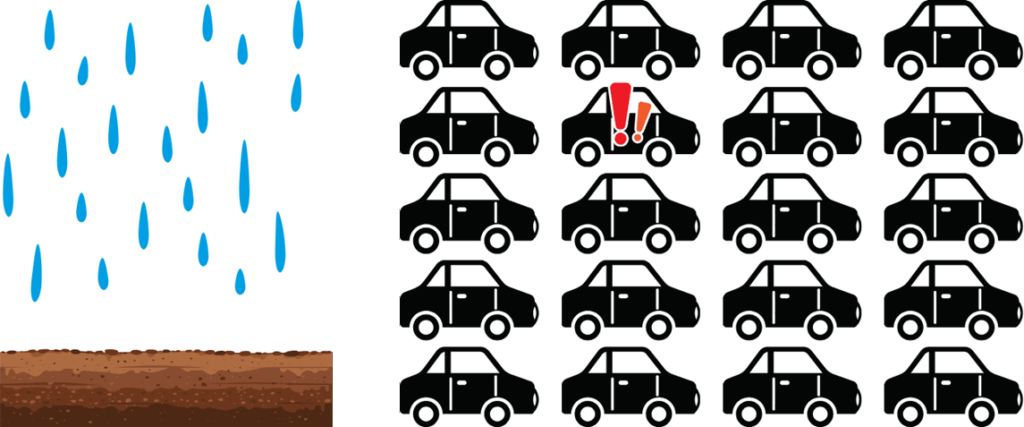
このように、ポアソン分布は「めったに起きない現象が、たくさんの機会の中でどれだけ起きるか」を扱う分布です。二項分布の世界を少し広げると、日常の「まれな出来事」をこのポアソン分布で説明できることが見えてきます。
③ 確率母関数
ポアソン分布の期待値と分散は、確率母関数からの導出がスムーズです。そこで先に確率母関数を導いておきましょう。まず、確率母関数の定義は以下の式でした。
\[
G(s) = E[s^{X}]
= \sum_{x = 0}^{\infty} s^{x} P(X = x)
\]
この定義にポアソン分布の確率関数を代入して以下のように整理すると、ポアソン分布の確率母関数の式を導けます。
\[\begin{align*}
G(s)
&= \sum_{x = 0}^{\infty} s^{x} e^{-\lambda} \dfrac{\lambda^{x}}{x!} \\[6pt]
&= e^{-\lambda} \sum_{x = 0}^{\infty} \dfrac{(\lambda s)^{x}}{x!} \\[6pt]
&= e^{-\lambda} e^{\lambda s} \\[6pt]
&= e^{\lambda (s – 1)}
\end{align*}\]
上記の2行目から3行目の展開では、以下のテイラー展開(より詳しくは「関数 \(f(u)=e^{u}\) に関する \(u=0\) まわりのテイラー展開(マクローリン展開)」)を利用しています。
\[
e^{t} = \sum_{x = 0}^{\infty} \dfrac{t^{x}}{x!}
\]
このテイラー展開において、 \(t=\lambda s\) とおくと以下の式が成り立ち、先ほどの確率母関数の式展開における2行目から3行目の展開となります。
\[
\sum_{x = 0}^{\infty} \dfrac{(\lambda s)^{x}}{x!} = e^{\lambda s}
\]
ポアソン分布の確率母関数は \(G(s)=e^{\lambda (s – 1)}\) というシンプルな指数関数の式となることから、期待値や分散も確率母関数からの導出がスムーズです。
④ 期待値と分散
それではポアソン分布の確率母関数から、期待値と分散を導出してみましょう。まず、確率母関数についての以下の基本公式を確認しておきます。
\[\begin{align*}
E[X] &= G^{\prime}(1),\quad E[X(X – 1)] = G^{\prime\prime}(1),\\[6pt]
V[X] &= G^{\prime\prime}(1) + G^{\prime}(1) – {G^{\prime}(1)}^{2}
\end{align*}\]
これを踏まえ確率母関数 \(G(s)\) の微分しておきます。なお、指数関数 \(e^{ax}\) を微分すると \(a e^{ax}\) であったことを思い出しておきましょう。
\[
G^{\prime}(s) = \lambda e^{\lambda (s – 1)},\quad
G^{\prime\prime}(s) = \lambda^{2} e^{\lambda (s – 1)}
\]
この式に \(s=1\) を代入します。
\[
G^{\prime}(1)=\lambda, \quad G^{\prime\prime}(1)=\lambda^{2}
\]
したがって、期待値と分散を以下のように導けます。
\[\begin{align*}
E[X] &= G^{\prime}(1) = \lambda \\[6pt]
V[X] &= G^{\prime\prime}(1) + G^{\prime}(1) – {G^{\prime}(1)}^{2}\\[6pt]
&=\lambda^{2} + \lambda \,- \lambda^{2} = \lambda
\end{align*}\]
つまり、ポアソン分布 \(X\sim Po(\lambda)\) の期待値と分散はともに \(\lambda\) となります。
⑤ 論点1:再生性
ポアソン分布は、二項分布と同様、再生性を有する分布です。いま、互いに独立な確率変数 \(X\) と \(Y\) がそれぞれ以下のようにポアソン分布にしたがうものとします。
\[
X \sim Po(\lambda_{1}), \quad Y \sim Po(\lambda_{2})
\]
このとき、確率変数の和を \(Z=X+Y\) とすると、 \(Z\) は以下のポアソン分布にしたがいます(ポアソン分布の再生性)。
\[
Z \sim Po(\lambda_{1}+\lambda_{2})
\]
再生性の証明
ポアソン分布の再生性は確率母関数により導けます。確率変数 \(X\) の確率母関数を \(G_{X}(s)\) 、確率変数 \(Y\) の確率母関数を \(G_{Y}(s)\) とすると、それぞれ以下のように表せます。
\[
G_{X}(s)=e^{\lambda_{1} (s – 1)}, \quad G_{Y}(s)=e^{\lambda_{2} (s – 1)}
\]
互いに独立な確率変数の和の確率母関数は、それぞれの確率母関数の積となりますので、 \(Z=X+Y\) の確率母関数 \(G_{Z}(s)\) を以下のように整理できます。
\[\begin{align*}
G_{Z}(s)&=G_{X}(s) \, G_{Y}(s)\\[6pt]
&=e^{\lambda_{1} (s – 1)} \cdot e^{\lambda_{2} (s – 1)}\\[6pt]
&=e^{\lambda_{1} (s – 1) + \lambda_{2} (s – 1)}\\[6pt]
&=e^{(\lambda_{1} + \lambda_{2}) (s – 1)}
\end{align*}\]
これは \(Po(\lambda_{1}+\lambda_{2})\) の確率母関数そのものです。母関数と確率分布は1対1の関係にありますので、 \(Z \sim Po(\lambda_{1}+\lambda_{2})\) と結論づけられます。
まとめ
ポアソン分布の再生性とは、独立に発生する事象を合算しても、分布の形が変わらないという性質です。パラメータ \(\lambda\) (平均発生件数)が単純に足し算されるだけで、分布そのものは再びポアソン分布のまま保たれます。
例えば、1時間あたり平均3件の着信がある電話回線Aと、平均2件の着信がある回線Bがあるとき、両方を合わせた全体の着信件数は、平均3+2=5のポアソン分布にしたがいます。これは「独立な現象をまとめても、分布の型が変わらない」ということを意味します。
この再生性は、ポアソン分布が複数の発生源を統合できる柔軟なモデルであることを示しています。交通量・来客数・欠陥品数・問い合わせ件数など、「独立な小さな発生が集まって全体を作る」現象を扱うとき、その背後では、まさにこのポアソン分布の再生性が働いているのです。
05. 幾何分布
① 概要
幾何分布(Geometric distribution)は、「ある事象が初めて成功するまでに、何回の失敗(あるいは試行)が必要か」という状況を扱う分布です。
前提の設定
同じ条件のもとで独立に繰り返されるベルヌーイ試行(成功か失敗か)を考えます。各試行で成功する確率を \(p\) 、失敗する確率を \(1-p\) とします。このとき、最初の成功が得られるまでの失敗回数を確率変数 \(X\) とすると、 \(X\) は幾何分布に従い、以下のように表記します。
\[
X\sim Geo(p)
\]
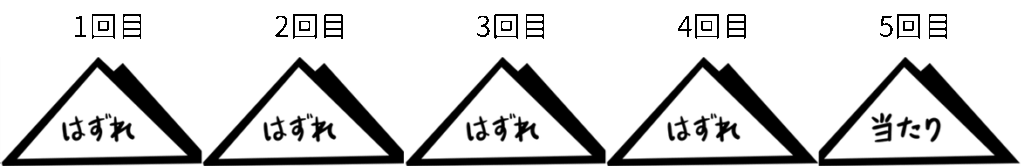
例えば、成功を「当たり」、失敗を「はずれ」と考えると、「くじで初めて当たるまでに何回はずれるか」についての確率を表します。
試行回数 or 失敗回数
幾何分布には、上記のように「(初めての成功までの)失敗回数」に焦点を当てたものの他に、「(初めての成功までの)試行回数」に焦点を当てた定義の仕方もあります。
| 定義の型 | 確率変数の意味 | 取る値 | 記号例 |
|---|---|---|---|
| ① 失敗回数型 | 最初の成功が出るまでの失敗回数 | \(0,1,2,\dots\) | \(Geo(p)\)(本記事はこちら) |
| ② 試行回数型 | 最初の成功が出るまでの試行回数 | \(1,2,3,\dots\) | \(Geo'(p)\)(別定義) |
どちらも本質的には同じ現象を表しますが、本記事では「失敗回数型(成功するまでの失敗回数)」の定義で統一します。
② 確率関数とグラフ
幾何分布 \(X \sim Geo(p)\) の確率関数は、「最初の成功が出るまでの失敗回数が \(x\) 回となる確率」を表します。式は以下の通りです。
\[
P(X=x)=(1−p)^{x}\,p,\;(x=0,1,2,…)
\]
ここで各項の意味を確認しておきましょう。
- \((1 – p)^{x}\):最初の \(x\) 回で連続して失敗する確率
- \(p\):そのあとの \(x\) 回目で初めて成功する確率
これを掛け合わせることで、「 \(x-1\) 回連続で失敗し、次で成功」という場合の確率が得られます。
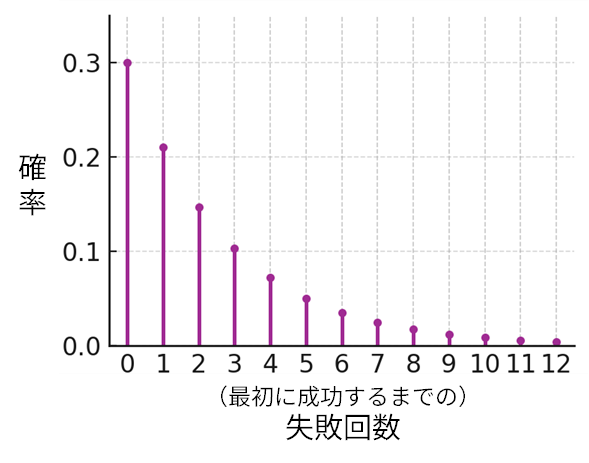
例えば、成功確率 \(p=0.3\) の試行について、「初めて成功するまでの失敗回数」がそれぞれの回数となる確率は以下の表のようになります。
| 失敗回数 (\(X\)) | 0回 | 1回 | 2回 | 3回 | 4回 |
|---|---|---|---|---|---|
| 確率 \(P(X=x)\) | 0.30 | 0.21 | 0.147 | 0.103 | 0.072 |
失敗を1回重ねるごとに、確率が \(1-p=0.7\) 倍ずつ減っていくことがわかります。つまり、幾何分布の確率は「右に行くほど指数的に小さくなる」形をしています。
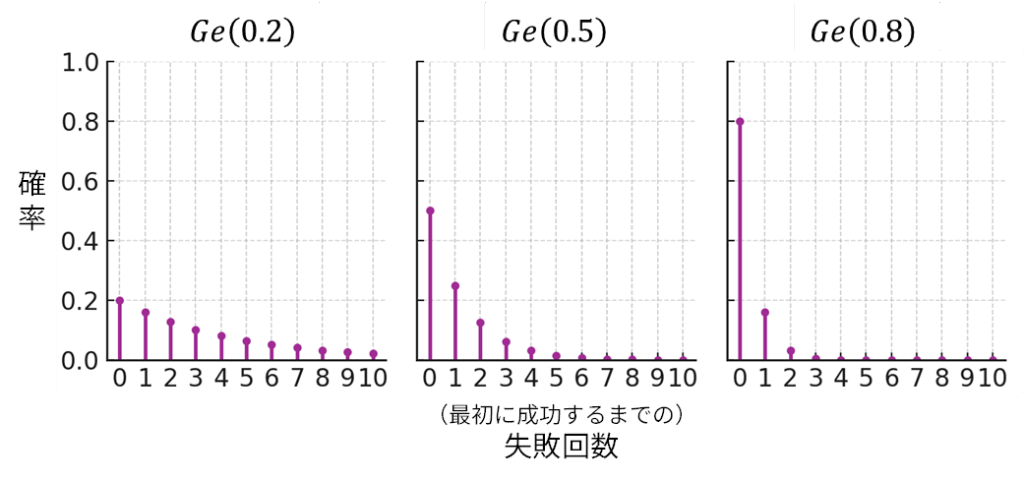
また、幾何分布のグラフは、成功確率 \(p\) が大きいほど、分布の山は左(小さい \(x\) )に寄り、すぐに成功する確率が高くなります。
③ 確率母関数
幾何分布の期待値と分散は、確率母関数からの導出がスムーズです。そこで先に確率母関数を導いておきましょう。まず、確率母関数の定義は以下の式でした。
\[
G(s) = E[s^{X}]
= \sum_{x = 0}^{\infty} s^{x} P(X = x)
\]
この定義に幾何分布の確率関数を代入して以下のように整理すると、幾何分布の確率母関数の式を導けます。
\[\begin{align*}
G(s)
&= \sum_{x = 0}^{\infty} s^{x} (1 – p)^{x} p \\[6pt]
&= p \sum_{x = 0}^{\infty} \left\{(1 – p)s \right\}^{x} \\[6pt]
\end{align*}\]
ここで、無限等比級数の公式というものを使います。無限等比級数とは以下のような形の和の計算のことです。なお、 \(r\) は公比と呼ばれる数で、各項の前の項に対する比率を表します。また、 \(k\) は項の番号で \(0,1,2,\dots\) と増えていく自然数です。
\[
1 + r + r^{2} + r^{3} + \cdots = \sum_{k = 0}^{\infty} r^{k}
\]
この無限等比級数は、公比 \(r\) が \(|r|<1\) のとき、有限の数(和)に収束します。これを表す式が以下の無限等比級数の公式です。
\[
\sum_{k = 0}^{\infty} r^{k} = \dfrac{1}{1 – r} \quad (|r| < 1)
\]
これを踏まえ、先ほどの確率母関数を整理した以下の式について、公比を \(r=(1-p)s\) とし、項番号を \(k=x=0,1,2,\dots\) と見れば、以下のように無限等比級数の公式を適用して幾何分布の確率母関数を整理できます。ただし、このとき \(|(1-p)s|<1\) である必要があることに注意しましょう。
\[\begin{align*}
G(s)
&= p \sum_{x = 0}^{\infty} \left\{(1 – p)s \right\}^{x} \\[6pt]
&= p \sum_{k = 0}^{\infty} r^{k} \\[6pt]
&= p \dfrac{1}{1 – r} \quad (|r|<1) \\[6pt]
&= \dfrac{p}{1 – (1-p)s} \quad (|(1-p)s|<1) \\[6pt]
\end{align*}\]
④ 期待値と分散
それでは幾何分布の確率母関数から、期待値と分散を導出してみましょう。まず、確率母関数についての以下の基本公式を確認しておきます。
\[\begin{align*}
E[X] &= G^{\prime}(1),\quad E[X(X – 1)] = G^{\prime\prime}(1),\\[6pt]
V[X] &= G^{\prime\prime}(1) + G^{\prime}(1) – {G^{\prime}(1)}^{2}
\end{align*}\]
確率母関数の微分
これを踏まえ確率母関数 \(G(s)\) の微分します。分母を \(D(s)=1-(1-p)s\) とおくと計算がスムーズです。なお、 \(D^{\prime}(s)=-(1-p)\) です。
\[\begin{align*}
G(s) &= \dfrac{p}{1 – (1-p)s}\\[6pt]
&= \dfrac{p}{D(s)}
\end{align*}\]
この確率母関数の微分では「商の微分公式」を用います。2つの関数 \(f(x)\) と \(g(x)\) を用いて、 \(y=\dfrac{f(x)}{g(x)}\) と表せる(つまり、関数の商として表せる)ならば、 商の微分公式は以下のように表されました。※詳しくはリンク(補足記事「高校数学で習う微分公式の整理」をご覧ください)
\[
\dfrac{dy}{dx}=\dfrac{f'(x)g(x)−f(x)g'(x)}{(g(x))^{2}}
\]
この商の微分公式の分子の関数 \(f\) として \(p\) 、分母の関数 \(g\) として \(D(s)\) を対応させると、確率母関数 \(G(s)\) の微分を以下のように整理できます。
\[\begin{align*}
G'(s)
&= \dfrac{(p)’ D(s) \; – \; (p) D'(s)}{ \left\{D(s)\right\}^{2}} \\[6pt]
&= \dfrac{0\times D(s) \; – \; p \, \left\{ – (1 – p)\right\}}{ \left\{D(s)\right\}^{2}}\\[6pt]
&= \dfrac{p (1 – p)}{\left\{1 – (1 – p)s\right\}^{2}} \\[6pt]
&= p \,(1-p) \; \left\{1 – (1 – p)s\right\}^{-2}
\end{align*}\]
続いて、上記の \(G^{\prime}(s)\) を再度微分した \(G^{\prime\prime}(s)\) を整理します。この部分の微分では合成関数の微分公式(チェーンルール)を用います。2つの関数 \(f(x)\) と \(g(x)\) について、 \(g(x)\) の結果をさらに \(f\) に代入した関数(合成関数) \(y=f(g(x))\) の微分(導関数)は以下の公式で導かれます。※こちらも詳しくはリンク(補足記事「高校数学で習う微分公式の整理」をご覧ください)
\[
\dfrac{dy}{dx}=f'(g(x)) \cdot g'(x)
\]
つまり、外側の関数 \(f(u)\) を微分して、続いて、内側の関数 \(g(x)\) を微分する、というルールです。この合成関数の微分公式を、先ほど導いた \(G'(s)\) の式に適用します。
具体的には、 \(u=1 – (1 – p)s\) とおきます。そして、外側の関数を \(f(u)=p(1-p)u^{-2}\) とし、内側の関数を \(g(s)= 1 – (1 – p)s\) として整理します。なお、ここでは \(s\) の関数の微分ですので、 \(g(x)\) ではなく \(g(s)\) としています。
まず外側の関数を( \(u\) について)微分します。
\[
f^{\prime}(u)=\left\{ p(1-p)u^{-2} \right\}^{\prime}=-2p(1-p)u^{-3}
\]
続いて内側の関数を( \(s\) について)微分します。
\[\begin{align*}
g^{\prime}(s)&=\left\{1 – (1 – p)s\right\}^{\prime}\\[6pt]
&=-(1-p)
\end{align*}\]
この「外側の関数の微分」と「内側の関数の微分」を掛け合わせます(合成関数の微分公式)。
\[\begin{align*}
G^{\prime\prime}(s)&=f^{\prime}(u) \cdot g^{\prime}(s)\\[6pt]
&=-2p(1-p)u^{-3} \cdot \left\{ -(1-p) \right\}\\[6pt]
&=2p(1-p)^{2}u^{-3}
\end{align*}\]
最後に \(u=1 – (1 – p)s\) を戻して、確率母関数の2階微分 \(G^{\prime\prime}(s)\) を以下のように整理できます。
\[\begin{align*}
G^{\prime\prime}(s)&=2p(1-p)^{2}\left\{1-(1-p)s\right\}^{-3}\\[6pt]
&=\dfrac{2p(1-p)^{2}}{\left\{1-(1-p)s\right\}^{3}}
\end{align*}\]
期待値・分散の導出
以上より、確率母関数の微分を以下のように導けました。
\[\begin{align*}
G^{\prime}(s)&= p\, (1-p) \; \left\{1 – (1 – p)s\right\}^{-2}\\[6pt]
G^{\prime\prime}(s)&=\dfrac{2p(1-p)^{2}}{\left\{1-(1-p)s\right\}^{3}}
\end{align*}\]
この式に \(s=1\) を代入します。
\[\begin{align*}
G^{\prime}(1)&= p \,(1-p)\; \left\{1 – (1 – p)\right\}^{-2}\\[6pt]
&=p (1-p)\cdot p^{-2}\\[6pt]
&=\dfrac{1-p}{p}\\[12pt]
G^{\prime\prime}(1)&=\dfrac{2p(1-p)^{2}}{\left\{1-(1-p)\right\}^{3}}\\[6pt]
&=\dfrac{2p(1-p)^{2}}{p^{3}}\\[6pt]
&=\dfrac{2(1-p)^{2}}{p^{2}}
\end{align*}\]
したがって、幾何分布の期待値と分散は以下のように導けます。
\[\begin{align*}
E[X] &= G^{\prime}(1)=\dfrac{1-p}{p}\\[10pt]
V[X] &= G^{\prime\prime}(1) + G^{\prime}(1) – {G^{\prime}(1)}^{2}\\[6pt]
&=\dfrac{2(1-p)^{2}}{p^{2}} + \dfrac{1-p}{p} – \big( \dfrac{1-p}{p} \big)^{2}\\[6pt]
&=\dfrac{2(1-p)^{2} + p(1-p) – (1-p)^{2}}{p^{2}}\\[6pt]
&=\dfrac{(1-p)^{2}+p(1-p)}{p^{2}}\\[6pt]
&=\dfrac{1-p}{p^2}
\end{align*}\]
つまり、成功確率 \(p\) が高いほど、「成功するまでの失敗回数の期待値」は少なく( \((1-p)/p\) が小さく)なり、同時にばらつき(分散)も小さくなります。一方で、成功確率 \(p\) が低いと、なかなか成功しないために失敗回数の期待値は多くなり、ばらつきも大きくなります。
⑤ 論点1:無記憶性
幾何分布の最大の特徴は、「過去を記憶しない」という性質をもつことです。これを無記憶性と呼びます。
無記憶性とは?
確率変数 \(X\) を「初めて成功するまでに要した失敗回数」としたとき、ある整数 \(k,\,m \geq 0\) について次の関係が成り立ちます。
\[
P(X \geq k + m \mid X \geq k) = P(X \geq m)
\]
左辺は、「初めての成功までに要する失敗回数 \(X\) 」について、「 \(X\) が \(k\) 回以上」という条件下における「 \(X\) が \(k+m\) 回以上」となる確率を表しています。つまり、「 \(k\) 回失敗したという条件下においてさらに \(m\) 回失敗する確率」です。この確率が右辺の「 \(X\) が \(m\) 回以上( \(m\) 回失敗する)の確率」と等しくなるということです。右辺には \(k\) 回という情報が用いられていない点がポイントです。
例えば、 \(k=100\) 回、 \(m=1\) 回として考えてみると以下のようになります。
\[
P(X \geq 100+1 \mid X \geq 100) = P(X \geq 1)
\]
つまり「 \(k=100\) 回失敗したという条件下においてさらにもう \(1\) 回失敗する確率」は「 \(1\) 回失敗する確率」に等しいということです。言い換えると、条件として与えられた \(k\) 回の情報がそれ以降の試行に影響を与えない(記憶されない)ということです。
数式による確認
幾何分布(試行回数型)において「初めて成功するまでに要した失敗回数」が \(k\) 以上となる確率 \(P(X \geq k)\) は、失敗(確率: \(1-p\) )が \(k\) 回続く必要がありますので、以下のように表せます。
\[
P(X \geq k) = (1-p)^{k}
\]
これを先ほどの式の左辺に代入して整理すると以下のようになります。
\[\begin{align*}
P(X \geq k + m \mid X \geq k)
&= \dfrac{P(X \geq k + m)}{P(X \geq k)} \\[9pt]
&= \dfrac{(1 – p)^{k + m}}{(1 – p)^{k}} \\[9pt]
&= (1 – p)^{m} \\[9pt]
&= P(X \geq m)
\end{align*}\]
確かに、右辺が \(k\) に依存していません。これがまさに「過去の失敗回数をまったく覚えていない」という無記憶性です。
無記憶性の例
あるテレフォンセールスの例を考えてみましょう。1件の電話が成約する確率が \(p=0.2\) (つまり \(20\%\) )だとします。このとき、5件連続で失敗したあとでも、次の1件で成約する確率はやっぱり\(0.2\) です。
「さっきまで何件失敗したか」は関係ありません。成功するまでの回数の分布は、毎回リセットされるようにふるまいます。「昨日10回断られたんだから、今日はそろそろ1件くらい…」という感覚は、人間の感情(ポジティブに言えば経験と勘、ノウハウ)であって、(仮に完全に独立なら)確率的には根拠がないということです。
06. 負の二項分布
① 概要
「成功するまでの失敗回数」を扱う幾何分布を思い出してみましょう。幾何分布では、成功確率 \(p\) の試行を繰り返し、初めて成功するまでの失敗回数を確率変数 \(X\) として扱いました。これに対して、負の二項分布では、「 \(r\) 回成功するまでに必要な失敗回数」を確率変数とします。
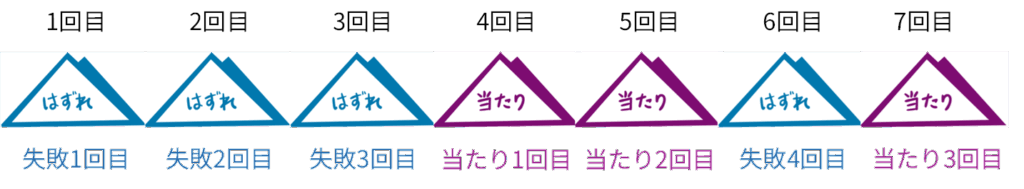
前提の確認
1回の試行で成功する確率が \(p\) 、失敗する確率が \(1-p\) の独立試行を繰り返すとします。そして、成功が \(r\) 回目( \(r\) は正の整数) に達した時点で試行を打ち切ります。このとき、確率変数 \(X\) を「そのときまでに起こった失敗の回数」とすると、 \(X\) は負の二項分布に従い、以下のように表記します。
\[
X \sim NB(r,p)
\]
- \(X\):\(r\) 回目の成功が起こるまでに生じた失敗回数
- \(r\):目標とする成功回数(固定値)
- \(p\):1回の試行の成功確率
例で考える
例えば、営業の成功確率が \(p=0.2\)(20%)のとき、「3件成約するまでに、何件の失敗を経験するか?」…この失敗件数が従うのが負の二項分布 \(NB(r=3, p=0.2)\) です。
1件成約するまで(=1回成功するまで)の失敗数だけを考える場合は、まさに幾何分布の形に一致します。つまり、 \(NB(1,p) = Geo(p)\) となります。
名前のイメージ
「負の二項分布」という名前は、二項定理の指数を「負の数」に拡張したときに出てくる係数(これを「負の二項係数」と呼びます)の形をもつことに由来しています。つまり、「二項分布のマイナス版」という意味ではなく、数学的に「負の指数をもつ二項展開」を用いた確率分布であるというイメージをもっておくとよいでしょう。なお、負の二項係数などの具体的な式については後程確認しましょう。
| 対応する概念 | 式のかたち | 分布での対応 |
|---|---|---|
| 二項定理 | \( (1+x)^n=\sum\binom{n}{k}x^k\) | 二項分布 \(Bin(n,p)\) |
| 負の二項定理 | \((1-x)^{-r}=\sum\binom{r+k-1}{k}x^k\) | 負の二項分布 \(NB(r,p)\) |
② 確率関数とグラフ
負の二項分布 \(X \sim NB(r,p)\) では、「 \(r\) 回成功するまでに生じた失敗回数 \(X\) 」の確率を求めます。ここで「 \(X=x\) 」となるのは、次の条件をすべて満たすときです。
最初の \(x+r-1\) 回の試行で成功が \(r-1\) 回、失敗が \(x\) 回起こる。
そして、最後の \(x+r\) 回目の試行で成功が起こる。
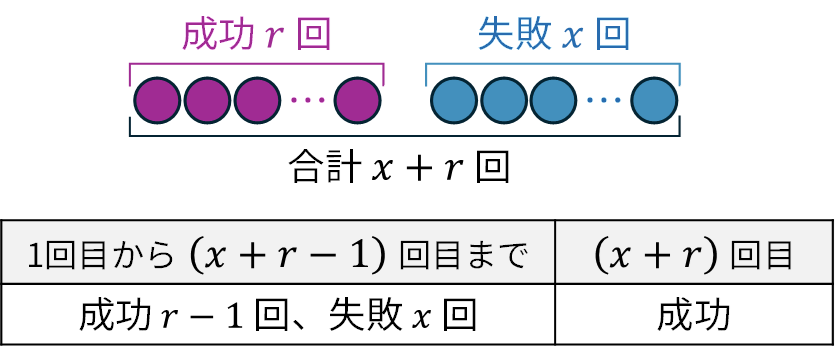
まず最後の1回は必ず成功となりますのでその確率は \(p\) です。また、それ以前( \(x+r-1\) 回)の試行結果は、成功 \(r-1\) 回、失敗 \(x\) 回の組み合わせにより構成され、その組み合わせは \(\binom{x+r-1}{x}\) 通りです。そして、それぞれの組み合わせの確率はいずれも \(p^{r-1}(1-p)^{x}\) です。
これらをすべて掛け合わせることで、負の二項分布 \(NB(r,p)\) の確率関数を以下のように導けます。
\[\begin{align*}
P(X = x)
&= p\times\binom{x + r – 1}{x} \, p^{r-1} (1 – p)^{x}\\[9pt]
&= \binom{x + r – 1}{x} \, p^{r} (1 – p)^{x}\\[9pt]
&\quad\; (x = 0, 1, 2, \ldots)
\end{align*}\]
例で考える
例えば、 \(r=3,\;p=0.4\) のとき、負の二項分布 \(NB(3,0.4)\) は「3回成功するまでに起こった失敗の回数」の確率分布を表します。このとき、 \(X=2\) というのは「合計5回の試行で、3回成功・2回失敗、最後が成功」というパターンを意味し、その確率を以下のように計算できます。
\[\begin{align*}
P(X=2)&=\binom{4}{2} (0.4)^3 (0.6)^2\\[6pt]
&=6 \times 0.064 \times 0.36\\[6pt]
&=0.1824
\end{align*}\]
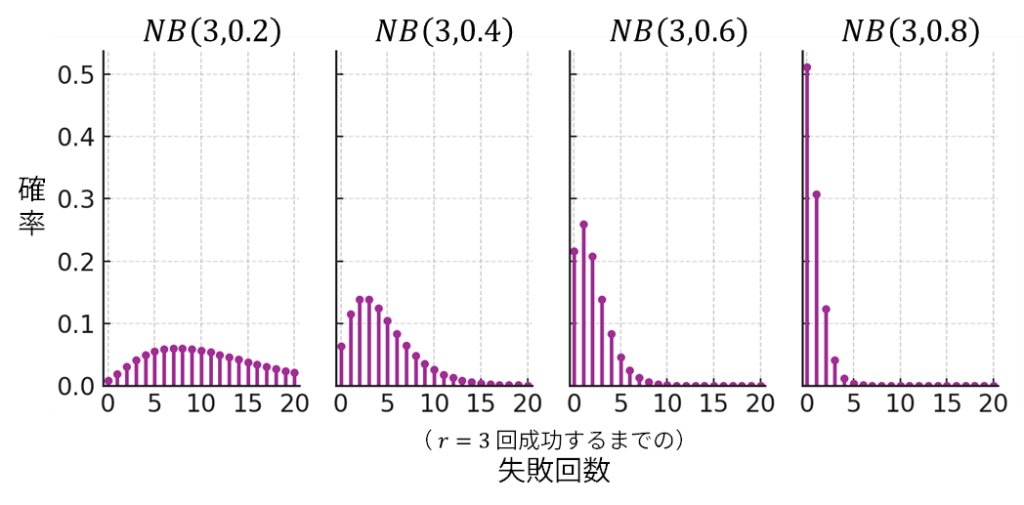
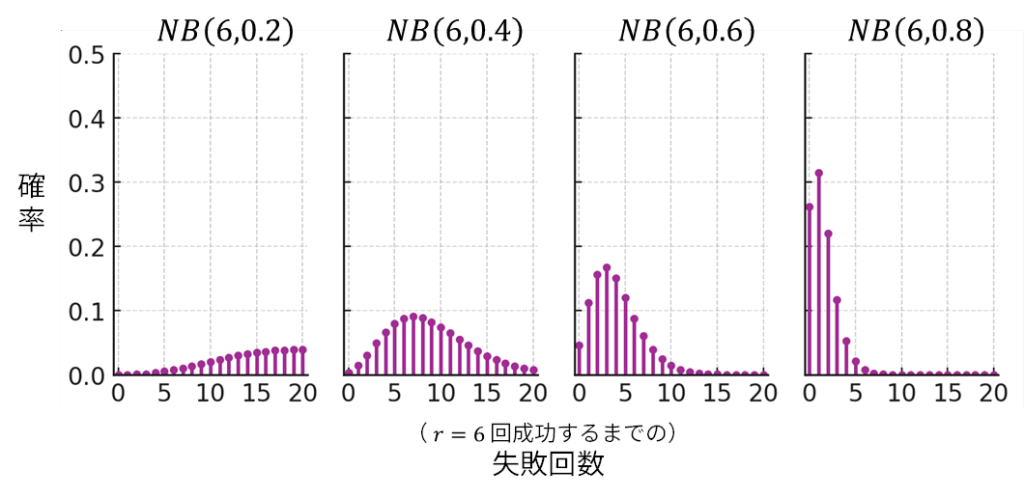
グラフの特徴
グラフは右に長く尾を引く右裾の分布になります。成功確率 \(p\) が小さいほど成功しづらいため、失敗回数の平均は大きくなり、分布の山が右側へずれていきます。また、目標成功回数 \(r\) が多いほど目標に到達しづらく、失敗回数の平均も大きくなります。
負の二項係数との関係
負の二項分布 \(NB(r,p)\) の確率関数には、次のような二項係数が含まれています。
\[
P(X=x)=\underbrace{\binom{x+r-1}{x}}_{\text{二項係数}} p^{r}(1-p)^{x}
\]
上記の二項係数の部分は、一般の「負の二項係数」と深く関係しています。まず、負の二項係数とは、二項係数を負の整数にまで拡張したもので、次のように定義されます。
\[
\binom{-r}{x}
= \overbrace{ \dfrac{(-r)(-r – 1)(-r – 2)\cdots(-r – x + 1)}{x!} }^{x\text{項}},
\quad (r > 0)
\]
この定義式について、分子の各項にはマイナス記号が含まれるため、全体で \((-1)^x\) をくくり出すことができます。
\[
\binom{-r}{x}
= (-1)^{x} \, \dfrac{r(r + 1)(r + 2)\cdots(r + x – 1)}{x!}
\]
すると、右辺の分子の並びはまさに \((x+r-1)(x+r-2)\cdots r\) の形(上記式とは並びの順番が逆であることに注意)になっており、次の関係が導けます。
\[
\binom{x + r \, – 1}{x}
= (-1)^{x} \binom{-r}{x}
\]
つまり、負の二項分布の確率関数に現れる \(\binom{x+r-1}{x}\) は、もともと「負の整数を上に持つ二項係数」 \(\binom{-r}{x}\) と対応しているのです。このことから「負の二項分布」という名称となっているものと認識しておくとよいでしょう。
③ 確率母関数
負の二項分布の確率母関数を導出しましょう。確率母関数の定義式に、負の二項分布 \(NB(r,p)\) の確率関数を代入して整理していきます。
\[\begin{align*}
G(s) &= E[s^{X}] = \sum_{x = 0}^{\infty} s^{x} P(X = x)\\[6pt]
&= \sum_{x = 0}^{\infty} s^{x} \binom{x + r – 1}{x} \, p^{r} (1 – p)^{x}\\[6pt]
&= p^{r} \sum_{x = 0}^{\infty} \binom{x + r – 1}{x} \, \left\{ (1 – p)s \right\} ^{x}
\end{align*}\]
ここで利用するのが「負の二項定理」です。これは、関数 \((1-a)^{-r}\) を \(a=0\) まわりでテイラー展開したもので、一般に次のように表されます。
\[\begin{align*}
&(1 – a)^{-r} \\[6pt]
&= 1 + r a + \dfrac{r(r + 1)}{2!} a^{2} + \dfrac{r(r + 1)(r + 2)}{3!} a^{3} + \cdots
\end{align*}\]
これを二項係数の形で書くと次のように整理できます。
\[
(1 – a)^{-r}
= \sum_{x = 0}^{\infty} \binom{r + x – 1}{x} a^{x},
\quad (|a| < 1)
\]
ここで、 \(a=(1-p)s\) とおくと、先ほどの確率母関数の式の一部を、以下のように整理できます。
\[
\sum_{x = 0}^{\infty} \binom{x + r – 1}{x} \, \left\{ (1 – p)s \right\} ^{x}
= \left\{ 1- (1-p)s \right\}^{-r}
\]
したがって、確率母関数は次のように導けます。
\[\begin{align*}
G(s)
&= p^{r} \sum_{x = 0}^{\infty} \binom{x + r – 1}{x} \, \left\{ (1 – p)s \right\} ^{x}\\[6pt]
&= p^{r} \left\{ 1- (1-p)s \right\}^{-r}\\[6pt]
&= \left\{ \dfrac{p}{1- (1-p)s} \right\}^{r} \quad (|(1 – p)s| < 1)
\end{align*}\]
幾何分布との関係
失敗回数型の幾何分布(成功までの失敗回数)の確率母関数は次の式でした。なお、負の二項分布の確率母関数との区別のために \(G_{Geo}(s)\) と表記することにします。
\[
G_{Geo}(s) = \dfrac{p}{1 – (1-p)s}
\]
これと比較すると、負の二項分布の確率母関数 \(G(s)\) は次のように書けます。
\[\begin{align*}
G(s)&=\left\{ \dfrac{p}{1- (1-p)s} \right\}^{r}\\[6pt]
&=\left\{ G_{Geo}(s) \right\}^{r}
\end{align*}\]
このことから、負の二項分布は「幾何分布」の独立な \(r\) 個の和の分布であることがわかります(独立な確率変数の和の確率母関数は、それぞれの確率母関数の積となることを思い出しておきましょう)。この結果は、次の節で期待値と分散を導く際にも役に立ちます。
ここでの説明は厳密な証明ではありません。確率母関数の積と和の関係には可逆性の問題もありますので、本来は「幾何分布の和として表せること」を和の確率母関数の式を整理しながら証明する必要があります。ここでは詳細な証明は省略しますが、実際に整理すると、幾何分布の和の確率母関数が、負の二項分布の確率母関数と一致することが確かめられます。
④ 期待値と分散
負の二項分布が「幾何分布」の独立な \(r\) 個の和の分布であることを利用して導出するのがスムーズです。いま、互いに独立に幾何分布にしたがう確率変数を \(Y_{i}\sim Geo(p)\) 、 \((i=1,2,\dots)\) とします。このとき、以下の和として得られる \(X\) が負の二項分布 \(NB(r,p)\) に従います。
\[
X=Y_{1}+Y_{2}+\cdots +Y_{r} \quad (Y_{i}\sim Geo(p))
\]
まあ、失敗回数型の幾何分布の期待値と分散は以下のように導きました。
\[
E[Y]=\dfrac{1-p}{p}, \quad V[Y]=\dfrac{1-p}{p^{2}}
\]
これを踏まえ、負の二項分布の期待値と分散を以下のように導けます。
\[\begin{align*}
E[X]&=\sum_{i=1}^{r} E[Y_{i}]=\dfrac{r(1-p)}{p}\\[6pt]
V[X]&=\sum_{i=1}^{r} V[Y_{i}]=\dfrac{r(1-p)}{p^{2}}
\end{align*}\]
例で考える
例えば、 \(p=0.3, \, r=4\) (成約率30%の営業で「4件成約」までの失敗回数)なら
\[\begin{align*}
E[X]&=\dfrac{4(1-0.3)}{0.3}=\dfrac{4\times0.7}{0.3}\approx 9.33\\[10pt]
\sqrt{V[X]}&=\sqrt{\dfrac{4(1-0.3)}{0.3^{2}}}\approx 3.05
\end{align*}\]
平均的には約9〜10件の失敗を経て4件の成功に到達し、標準偏差は約3件程度という見通しになります。
⑤ 論点1:再生性
負の二項分布 \(NB(r,p)\) は「成功確率 \(p\) の試行で、成功が \(r\) 回に到達するまでに生じる失敗回数」でした。いま、同じ成功確率 \(p\) を前提として、独立な2つの試行過程による失敗回数 \(X_{1},X_{2}\) を考えてみます。
\[
X_{1} \sim NB(r_{1}, \, p), \quad X_{2} \sim NB(r_{2}, \, p)
\]
このとき、独立な2つの試行過程による失敗回数の合計 \(X_{1}+X_{2}\) は以下の負の二項分布に従います。なお、\(X_{1}\) と \(X_{2}\) が互いに独立で、同一の成功確率 \(p\) である必要があることに注意しましょう。
\[
X_{1}+X_{2} \sim NB(r_{1}+r_{2}, \, p)
\]
確率母関数による証明
負の二項分布(失敗回数型)の確率母関数は次の式でした。
\[
G(s)=\left\{ \dfrac{p}{1- (1-p)s} \right\}^{r}
\]
これを踏まえ、 \(X_{1}+X_{2}\) の確率母関数 \(G_{X_{1}+X_{2}}(s)\) を次のように整理します。なお、独立な和の確率母関数は、それぞれの確率母関数の積であることに注意しましょう。
\[\begin{align*}
G_{X_{1}+X_{2}}(s)&=G_{X_{1}}(s)\, G_{X_{2}}(s)\\[6pt]
&=\left\{ \dfrac{p}{1- (1-p)s} \right\}^{r_{1}} \; \left\{ \dfrac{p}{1- (1-p)s} \right\}^{r_{2}}\\[6pt]
&=\left\{ \dfrac{p}{1- (1-p)s} \right\}^{r_{1}\,+\,r_{2}}
\end{align*}\]
この最後の式はまさしく \(NB(r_1+r_2, p)\) の確率母関数の式です。確率母関数と確率分布は1対1の関係にありますので、 \(X_{1}+X_{2}\sim NB(r_{1}+r_{2},p)\) となることを示せました。
例で考える
不良率 \(p=0.3\) の検査を、ラインAとラインBで以下のように実施するものとします。
- ラインAでは「合格を \(r_1=2\) 回得るまでの不合格数 \(X_{1}\) 」をカウント
:\(X_1\sim NB(2,0.3)\) - ラインBでは「合格を \(r_2=3\) 回得るまでの不合格数 \(X_{2}\) 」をカウント
:\(X_2\sim NB(3,0.3)\)
このとき、両ラインの不合格数を合算すると、「合格5回達成までの不合格総数( \(X_{1}+X_{2}\) )」となり、そのしたがう分布が以下のようになります。
\[
X_1+X_2\sim NB(5,0.3)
\]
07. 多項分布
① 概要
多項分布(multinomial distribution)は、「結果が複数(2つ以上)存在する試行を、独立に \(n\) 回繰り返したときの結果の回数(組)」が従う分布です。多項分布は記号が多く登場して混乱しやすいので、先に登場する記号を以下のように整理しておきます。
- 結果の種類:\(j=1,2,…,K \; (K\ge2)\)
- 1回の試行で結果 \(j\) が起こる確率:\(p_j\)
- \(n\) 回の試行のうち結果 \(j\) が出た回数:\(Y^{(j)}\)
このとき確率変数列 \(Y=(Y^{(1)},Y^{(2)},\dots Y^{(K)})\) は多項分布にしたがい、記号では以下のように表記します。
\[
Y \sim M(n \, ; \, p_{1},p_{2},\dots,p_{K})
\]
ただし、確率の総和は \(\sum_{j=1}^{K}p_{j}=1\) で、回数の総和は \(\sum_{j=1}^{K}Y^{(j)}=n\) です。
K=2の場合(コインの例)
2種類の結果(例:表・裏)がある場合を考えてみましょう。それぞれの確率を \(p_1=p\) 、 \(p_2=1-p\) とします。このときの確率変数列は \(Y=(Y^{(1)},Y^{(2)})\) となりますが、 \(Y^{(2)}\) については、\(Y^{(2)}=n-Y^{(1)}\) と表せます。
つまり、2つの成分のうち1つが決まればもう一方も自動的に定まるため、確率的には1変数( \(Y^{(1)}\) )だけを考えれば十分と言えます。したがって、2次元の多項分布は実質的に1変数の二項分布に一致します
\[
Y^{(1)}\sim Bin(n,p)
\]
この \(K=2\) の場合は、二項分布と多項分布のつながりを示す典型的な例です。二項分布では「成功した回数」という1次元の結果のみを扱っていましたが、多項分布ではこれを拡張し、「結果1が出た回数」、「結果2が出た回数」、…、「結果Kが出た回数」という複数の結果を同時に確率変数として扱います。
つまり、多項分布は「二項分布を多次元に一般化した分布」であり、各成分 \(Y^{(j)}\) がそれぞれのカテゴリの出現回数を表す、多次元の「回数(組)の分布」なのです。
K=3 の場合(箱の玉の例)
箱のなかに3種類の玉(例:赤玉・白玉・青玉)があり、それぞれの玉が出る確率が \(p_1,p_2,p_3\) で、 \(p_1+p_2+p_3=1\) とします。
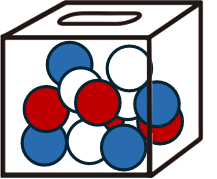
この箱から1個ずつ玉を取り出しては戻すという試行を \(n=10\) 回行ったとします。10回のうち赤が出た回数を \(Y^{(1)}\) 、白が \(Y^{(2)}\) 、青が \(Y^{(3)}\) とすると、 \(Y=(Y^{(1)},Y^{(2)},Y^{(3)})\) が従う分布は以下のようになります。
\[
Y\sim M(10; p_1,p_2,p_3)
\]
1回ごとの結果は独立であり、各回で必ずどれか1つの結果が出るため、それぞれの回数の合計は \(n=10\) となります。
\[
Y^{(1)}+Y^{(2)}+Y^{(3)}=10
\]
したがって、多項分布は「全体の合計が固定された上で、各結果カテゴリーに振り分けられる回数(組)の確率分布」と考えることができます。
まとめ
多項分布は、二項分布を「2分類 → K分類」に拡張したものです。1回の試行で「どれが起きるか」を表す多値的な確率変数を、同じ条件で \(n\) 回繰り返したときの各結果の出現回数の分布が、多項分布 \(M(n; p_1,p_2,…,p_K)\) です。
② 確率関数とグラフ
多項分布の確率関数は、それぞれの結果 \(j\) ( \(1 \leq j \leq K\) )について、「結果 \(j\) が \(y^{(j)}\) 回起こる」という確率を計算するもので、以下のように表記します。
\[
P(Y^{(1)}=y^{(1)},\,Y^{(2)}=y^{(2)},\,\dots,\,Y^{(K)}=y^{(K)})
\]
で表します。
この確率は、次の2つの要素から成り立ちます
① 組み合わせ総数(何通りの並びがあるか)
1回の試行で出る結果は \(K\) 種類あります。「 \(n\) 回の試行のうち、結果 \(1\) が \(y^{(1)}\) 回、結果 \(2\) が \(y^{(2)}\) 回、…、結果 \(K\) が \(y^{(K)}\) 回出た」という並び方の総数は、以下のようになります。
\[
\dfrac{n!}{y^{(1)}! \, y^{(2)}! \cdots y^{(K)}!}
\]
これは、次のように段階的に考えるとわかりやすいです。
- まず、 \(n\) 回のうち \(y^{(1)}\) 回が結果1になる組み合わせは \(\binom{n}{y^{(1)}}\) 通り。
- 残り \(n-y^{(1)}\) 回のうち \(y^{(2)}\) 回が結果2になる組み合わせは \(\binom{n-y^{(1)}}{y^{(2)}}\) 通り。
- 同様に、次々と決めていくと、全体では以下のように整理できます。
\[
\binom{n}{y^{(1)}}\,\binom{n-y^{(1)}}{y^{(2)}}\,\binom{n-y^{(1)}-y^{(2)}}{y^{(3)}}\cdots\\[10pt]
=\dfrac{n!}{y^{(1)}!\,y^{(2)}!\,\cdots\,y^{(K)}!}
\]
② その組み合わせとなる確率
1回の試行で結果 \(j\) が出る確率は \(p_j\) なので、特定の試行列で「結果 \(1\) が \(y^{(1)}\) 回、結果 \(2\) が \(y^{(2)}\) 回、…、結果 \(K\) が \(y^{(K)}\) 回」出る確率は以下のように表せます。
\[
p_{1}^{y^{(1)}}p_{2}^{y^{(2)}}\cdots p_{K}^{y^{(K)}}
\]
多項分布の確率関数:①×②
上記の①と②を掛け合わせることで多項分布の確率関数を導けます。
\[\begin{align*}
&P(Y^{(1)}=y^{(1)},\,Y^{(2)}=y^{(2)},\,\dots,\,Y^{(K)}=y^{(K)})\\[6pt]
&=\dfrac{n!}{y^{(1)}!\,y^{(2)}!\,\cdots\,y^{(K)}!} \; p_{1}^{y^{(1)}}p_{2}^{y^{(2)}}\cdots p_{K}^{y^{(K)}}
\end{align*}\]
ただし、 \(\sum_{j=1}^{K} y^{(j)}=n\) であることに注意しましょう。
例で考える
例えば、結果が \(K=3\) 個とし、1回の試行においてそれぞれの結果 \(1,2,3\) となる確率が以下のように仮定できるものとします。
\[
p_{1}=0.3,\; p_{2}=0.6,\; p_{3}=0.1
\]
このとき、試行回数が \(n=10\) 回のうち、結果 \(1\) が起こる回数が \(Y^{(1)}=3\) 回、結果 \(2\) が起こる回数が \(Y^{(2)}=5\) 回、結果 \(3\) が起こる回数が \(Y^{(3)}=2\) 回となる確率は以下のようになります。
\[\begin{align*}
&P(Y^{(1)}=3,\,Y^{(2)}=5,\,Y^{(3)}=2)\\[6pt]
&=\dfrac{10!}{3!\,5!\,2!} \; (0.3)^{3} \; (0.6)^{5} \; (0.1)^{2}\\[6pt]
&=\;\text{(計算省略)} \approx 0.053 \; (5.3\%)
\end{align*}\]
③ 期待値と分散
1. まずは1回の試行から考える
1回の試行だけを考え、それを以下のように表します。
\[
X=(X^{(1)},X^{(2)},\ldots,X^{(K)}) \sim M(1; p_1,p_2,\ldots,p_K)
\]
ここで、 \(X^{(j)}\) は「結果 \(j\) が出たら \(1\) 、出なければ \(0\) 」とする変数です。1回の試行では必ずどれか1つの結果だけが起こるため、同時に2つの結果が起こることはありません。この性質が、後で確認する共分散に影響します。
2. \(n=1\) のときの期待値・分散・共分散
結果 \(j\) が出る確率は \(p_j\) なので、期待値は次のようになります。
\[
E[X^{(j)}] = p_j
\]
\(X^{(j)}\) は結果が「出る(1)/出ない(0)」の2値変数なので、その分散はベルヌーイ分布 \(Bern(p_j)\) の分散に一致します。
\[
V[X^{(j)}] = p_{j}(1−p_{j})
\]
また、異なる結果 \(i\) と \(j\) の同時発生はありえません。したがって、 \(i \neq j\) のとき、積 \(X^{(i)}X^{(j)}\) が常に0となることから、その期待値も0となります。
\[
E[X^{(i)}X^{(j)}] = 0
\]
このときの共分散は次のように計算されます。
\[\begin{align*}
\operatorname{Cov}(X^{(i)},X^{(j)}) &= E[X^{(i)}X^{(j)}] \, -\, E[X^{(i)}]E[X^{(j)}]\\[6pt]
&= -p_i \, p_j
\end{align*}\]
よってまとめると、1回の試行では次の関係が成り立ちます。
\[\begin{align*}
&E[X^{(j)}]=p_j\\[6pt]
&V[X^{(j)}]=p_j\,(1-p_j)\\[6pt]
&\operatorname{Cov}(X^{(i)},X^{(j)})=-p_i \, p_j \ (i\neq j)
\end{align*}\]
3. \(n\) 回試行した場合(多項分布)
次に、同じ確率 \(p_1,\ldots,p_K\) で独立に \(n\) 回試行したとします。そのときの結果の回数をまとめた確率変数列を次のように表します。
\[
Y=(Y^{(1)},Y^{(2)},\ldots,Y^{(K)}) \sim M(n; p_1,p_2,\ldots,p_K)
\]
各成分 \(Y^{(j)}\) は、「 \(n\) 回のうち、結果 \(j\) が起こった回数」を表します。また、1回ごとの結果を \(t=1,2,\ldots,n\) として区別し、そのときの各結果を \(X_t^{(j)}\) と書けば、次のように表すことができます。
\[
Y^{(j)} = \sum_{t=1}^{n} X_t^{(j)}
\]
ここで、各試行 \(t\) は互いに独立であり、それぞれの \(X_t^{(j)}\) は「1回の試行 \(t\) において結果 \(j\) が出たかどうか(1または0)」を示す変数です。
多項分布の期待値・分散・共分散
上記を踏まえ、多項分布に従う確率変数列 \(Y\) における各成分 \(Y^{(j)}\) の期待値を以下のように導けます。
\[\begin{align*}
E[Y^{(j)}]
&= E\!\left[ \sum_{t = 1}^{n} X_{t}^{(j)} \right]\\[6pt]
&= \sum_{t = 1}^{n} E[X_{t}^{(j)}]\\[6pt]
&= n p_{j}
\end{align*}\]
つまり、「 \(n\) 回中、確率 \(p_j\) の事象が起こる回数の期待値」は、単純に \(n\) 倍したものになります。
また、各試行は独立なので、分散も同様に以下のように導けます。
\[\begin{align*}
V[Y^{(j)}]
&= V\!\left[ \sum_{t = 1}^{n} X_{t}^{(j)} \right]\\[6pt]
&= \sum_{t = 1}^{n} V[X_{t}^{(j)}]\\[6pt]
&= n\,p_{j}\,(1 – p_{j})
\end{align*}\]
したがって、各カテゴリの回数は二項分布 \(Bin(n,p_j)\) と同じ分散をもちます。
最後に多項分布の共分散を整理します。多項分布の共分散は「確率変数列 \(Y\) の異なる結果成分 \(Y^{(i)}\) と \(Y^{(j)}\) の共分散」のことですが、混乱しやすいので最初に記号の意味を整理しておきましょう。
まず、各成分は「試行ごとの結果の合計」ですので、以下のように定義しておきます。
\[
Y^{(i)}=\sum_{t=1}^{n} X^{(i)}_{t}, \qquad Y^{(j)}=\sum_{s=1}^{n} X^{(j)}_{s}
\]
- \(X_{t}^{(i)}\):\(t\) 回目の試行で「結果 \(i\) が出たら \(1\) 、出なければ \(0\) 」
- \(X_{s}^{(j)}\):\(s\) 回目の試行で「結果 \(j\) が出たら \(1\) 、出なければ \(0\)」
- 試行と試行は独立( \(t\neq s\) なら独立)
- 同一試行内では、同時に2つの結果は起きない( \(i\neq j\) なら \(X_{t}^{(i)}\,X_{t}^{(j)}=0\) )
この準備のうえで、共分散を展開します。
\[\begin{align*}
\operatorname{Cov}(Y^{(i)}, \, Y^{(j)})
&= \operatorname{Cov}\!\left(
\sum_{t = 1}^{n} X_{t}^{(i)},\,
\sum_{s = 1}^{n} X_{s}^{(j)}
\right) \\[6pt]
&= \sum_{t = 1}^{n} \sum_{s = 1}^{n}
\operatorname{Cov}\!\left( X_{t}^{(i)}, \,X_{s}^{(j)} \right)
\end{align*}\]
試行が異なれば独立なので、 \(t\neq s\) の項は 0 です。したがって、 \(t=s\) の項だけが残ります。
\[
\operatorname{Cov}(Y^{(i)}, \, Y^{(j)})
= \sum_{t = 1}^{n} \operatorname{Cov}\!\left( X_{t}^{(i)}, \, X_{t}^{(j)} \right)
\]
1回の試行内では
\(E[X_{t}^{(i)}]=p_i,\;E[X_{t}^{(j)}]=p_j,\;E[X_{t}^{(i)} \, X_{t}^{(j)}]=0\) (同時発生はないので)なので、
\[\begin{align*}
\operatorname{Cov}\!\left(X_{t}^{(i)}, X_{t}^{(j)}\right)
&= E\!\left[X_{t}^{(i)} X_{t}^{(j)}\right] \,-\, E\!\left[X_{t}^{(i)}\right] \, E\!\left[X_{t}^{(j)}\right] \\[6pt]
&= 0 \, – p_{i} \, p_{j} \\[6pt]
&= -\,p_{i} \, p_{j}
\end{align*}\]
よって、最終的に共分散を以下のように導けます。
\[\begin{align*}
\operatorname{Cov}(Y^{(i)}, \, Y^{(j)})
&= \sum_{t = 1}^{n} \left( -p_{i} \, p_{j} \right) \\[6pt]
&= -\,n\,p_{i} \,p_{j} \quad (i \ne j)
\end{align*}\]
④ 確率母関数
まず、「確率変数列(多変量)の確率母関数」を次のように定めます( 確率変数「列」に対応する確率母関数であるため、 \(K\) 個の変数 ( \(s_1,\dots,s_K\) )をとる関数です)。
\[
G_{Y}(s_{1}, \dots, s_{K})
= E\!\left[ s_{1}^{Y^{(1)}} s_{2}^{Y^{(2)}} \cdots s_{K}^{Y^{(K)}} \right]
\]
ステップ1:1回試行の確率母関数を作る
1回の試行だけを考え、各カテゴリーについての結果ベクトルを次のように置きます。
\[
X=(X^{(1)},\dots,X^{(K)}) \sim M(1; p_1,\dots,p_K)
\]
このときの確率母関数は次の1行にまとまります(1回の試行では、どれか1つだけが起こるためです。例えば \(X_{1}=1\) なら、それ以外の \(X_{i}\) は0になります)。
\[\begin{align*}
G_X(s_1,\dots,s_K)&=E\!\left[s_1^{X^{(1)}}\cdots s_K^{X^{(K)}}\right]\\[6pt]
&= p_1 s_1 + p_2 s_2 + \cdots + p_K s_K
\end{align*}\]
ステップ2:\(n\) 回試行の確率母関数は“積”になる
同じ条件で独立に \(n\) 回試行した合計を、次のように定めます。
\[
Y=(Y^{(1)},\dots,Y^{(K)}) \sim M(n; p_1,\dots,p_K)
\]
各成分は、各結果カテゴリーにおける \(n\) 回の結果の総和とします。
\[
Y^{(j)} = \sum_{t = 1}^{n} X_{t}^{(j)}
\]
独立な確率変数の和の確率母関数は、各々の確率母関数の積になるため、次の関係が成り立ちます。なお、 \(prod\) 記号(パイ)は総乗記号で、例えば \(\prod_{t=1}^{3}a_{t}=a_{1} a_{2} a_{3}\) です。
\[\begin{align*}
G_{Y}(s_{1}, \dots, s_{K})
&= \prod_{t = 1}^{n} G_{X_{t}}(s_{1}, \dots, s_{K})\\[6pt]
&= \left\{ G_{X}(s_{1}, \dots, s_{K}) \right\}^{n}
\end{align*}\]
したがって、1回試行の確率母関数 \(G_{X}(s_{1},\dots,s_{K})\) の式を代入すると、多項分布の確率母関数を以下のように導けます。
\[
G_Y(s_1,\dots,s_K) = \bigl(p_1 s_1 + \cdots + p_K s_K\bigr)^{n}
\]
⑤ 論点1:再生性
多項分布も、二項分布やポアソン分布と同じように「再生性」をもっています。再生性とは、同じ確率構造をもつ独立な分布を足し合わせたときに、もとの分布と同じ型の分布が得られる性質のことです。
例で考える
あるアンケート調査で、回答が次の3種類に分かれているとします。
- A:「はい」と答える確率 \(p_1=0.5\)
- B:「いいえ」と答える確率 \(p_2=0.3\)
- C:「無回答」となる確率 \(p_3=0.2\)
午前中に100人、午後に150人、それぞれ独立に調査を行ったとします。
このとき、午前の結果を
\[
Y_{1} = \bigl( Y_{1}^{(1)},\, Y_{1}^{(2)},\, Y_{1}^{(3)} \bigr)
\sim M(100;\, p_{1}, p_{2}, p_{3})
\]
午後の結果を
\[
Y_{2} = \bigl( Y_{2}^{(1)},\, Y_{2}^{(2)},\, Y_{2}^{(3)} \bigr)
\sim M(150;\, p_{1}, p_{2}, p_{3})
\]
とすると、1日全体の結果は以下のように表せます。
\[
Y=Y_{1}+Y_{2}
\]
このとき、全体の \(Y\) も次の多項分布に従います。
\[
Y \sim M(100+150\; ; \; p_1, p_2, p_3)
\]
すなわち、試行回数(ここでは調査人数) \(n\) が足し合わされるだけで、確率 \(p_j\) は変わらないのです。これが多項分布の「再生性」です。
確率母関数による導出
1回試行の確率母関数は以下の式になります(今回は \(K=3\) であることに注意しましょう)。
\[
G_X(s_1, s_2, s_3) = p_1 s_1 + p_2 s_2 + p_3 s_3
\]
したがって、午前・午後に対応する確率母関数はそれぞれ以下のようになります。
\[\begin{align*}
G_{Y_{1}}(s_{1}, s_{2}, s_{3})
&= \left( p_{1}s_{1} + p_{2}s_{2} + p_{3}s_{3} \right)^{100}\\[6pt]
G_{Y_{2}}(s_{1}, s_{2}, s_{3})
&= \left( p_{1}s_{1} + p_{2}s_{2} + p_{3}s_{3} \right)^{150}
\end{align*}\]
互いに独立なため、全体(和) \(Y=Y_1+Y_2\) の確率母関数は、各々の確率母関数の積になります。
\[\begin{align*}
G_{Y}(s_{1}, s_{2}, s_{3})
&= G_{Y_{1}}(s_{1}, s_{2}, s_{3}) \;
G_{Y_{2}}(s_{1}, s_{2}, s_{3})\\[6pt]
&= \left( p_{1}s_{1} + p_{2}s_{2} + p_{3}s_{3} \right)^{250}
\end{align*}\]
この式は、もとの多項分布の確率母関数( \(n=250\) )とまったく同じになっていることから、全体(和) \(Y=Y_1+Y_2\) の従う分布も多項分布であること、すなわち、再生性を確認できました。
\[
Y \sim M(250;\, p_{1}, p_{2}, p_{3})
\]
08. 確率分布マップ(まとめ)
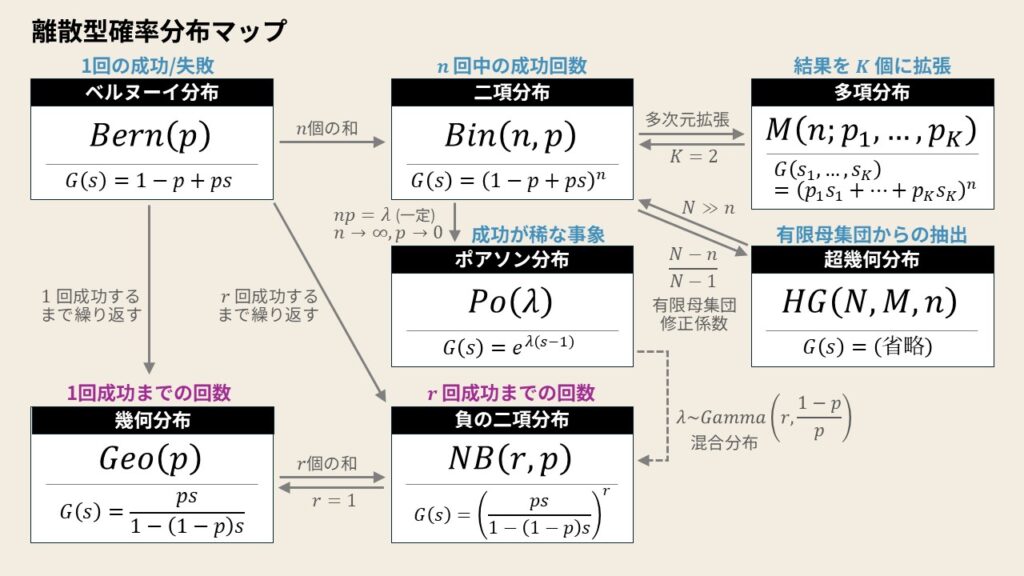
ここまで学んできた離散型確率分布を、1枚のマップとして整理したものが上図です。ポイントは、各分布が“個別の存在”としてバラバラにあるのではなく、互いに明確なつながりをもっているということです。
まず、すべての出発点となるのが「1回の成功/失敗」を表す ベルヌーイ分布 です。そこから
- 「同じ試行を \(n\) 回繰り返す」→ 二項分布
- 「成功するまで繰り返す」→ 幾何分布
- 「成功 \(r\) 回まで繰り返す」→ 負の二項分布
というように、“何を固定し、何をランダムにするか” の違いによって派生していきます。
さらに、二項分布は
- 成功確率 \(p\) が小さく、試行回数 \(n\) が大きいとき → ポアソン分布(近似)
- 結果を \(2\) 種類ではなく \(k\) 種類に一般化すると → 多項分布
- 抽出が「非復元(戻さない)」に変わると → 超幾何分布
というように、前提条件をどう変えるかによって形を変えます。
また、ポアソン分布だけは少し特殊で、“平均 \(\lambda\) を確率変数として揺らがせる” という発想を加えると、負の二項分布が得られます(「ポアソン–ガンマ混合分布」といいます。混合分布の詳細はまた別の回でご紹介します)。
このように、離散型確率分布は「ただ暗記する」だけではなく、ひとつのストーリーとして整理すると理解がより深まります。上記のマップも学習の参考にご活用いただけますと幸いです(マップの画像はSNSでのシェアも大歓迎です。その場合はぜひ公式LINEもご紹介いただけますとありがたいです)。